
[VLAM] 07 Open X-Embodiment
Published:
In this post, Open X-Embodiment is introduced.
Open X-Embodiment: Robotic Learning Datasets and RT-X Models
1. Introduction
대규모의 다양한 데이터셋으로 학습된 범용 모델은, 더 작고 특정 작업에 특화된 데이터로 학습된 모델보다 더 뛰어난 성능을 보이는 경우가 많다. 예를 들어, 웹에서 수집된 대규모 데이터셋으로 학습된 Open Vocabulary Classifier (미리 정해진 클래스(label)에만 제한되지 않고 새로운 텍스트도 클래스로 인식할 수 있는 모델, e.g CLIP 등) 는 제한된 데이터셋으로 학습된 고정된 보캐불러리 모델보다 우수한 성능을 보인다.
그러나 이러한 교훈은 로보틱스에는 적용하기 어렵다. 하나의 로봇 도메인은 너무 좁고, 컴퓨터 비전이나 NLP처럼 웹에서 대규모 데이터를 확보하기도 어렵기 때문이다. 실제로 가장 큰 데이터 수집 노력조차도 비전(5–18M)이나 NLP(1.5B–4.5B)에 비해 훨씬 작은 규모와 다양성을 가진 데이터셋에 머무른다. 더 중요한 것은 이러한 데이터셋이 여전히 특정 환경, 특정 객체 집합, 혹은 제한된 작업 범위에 치우쳐 있다는 점이다.
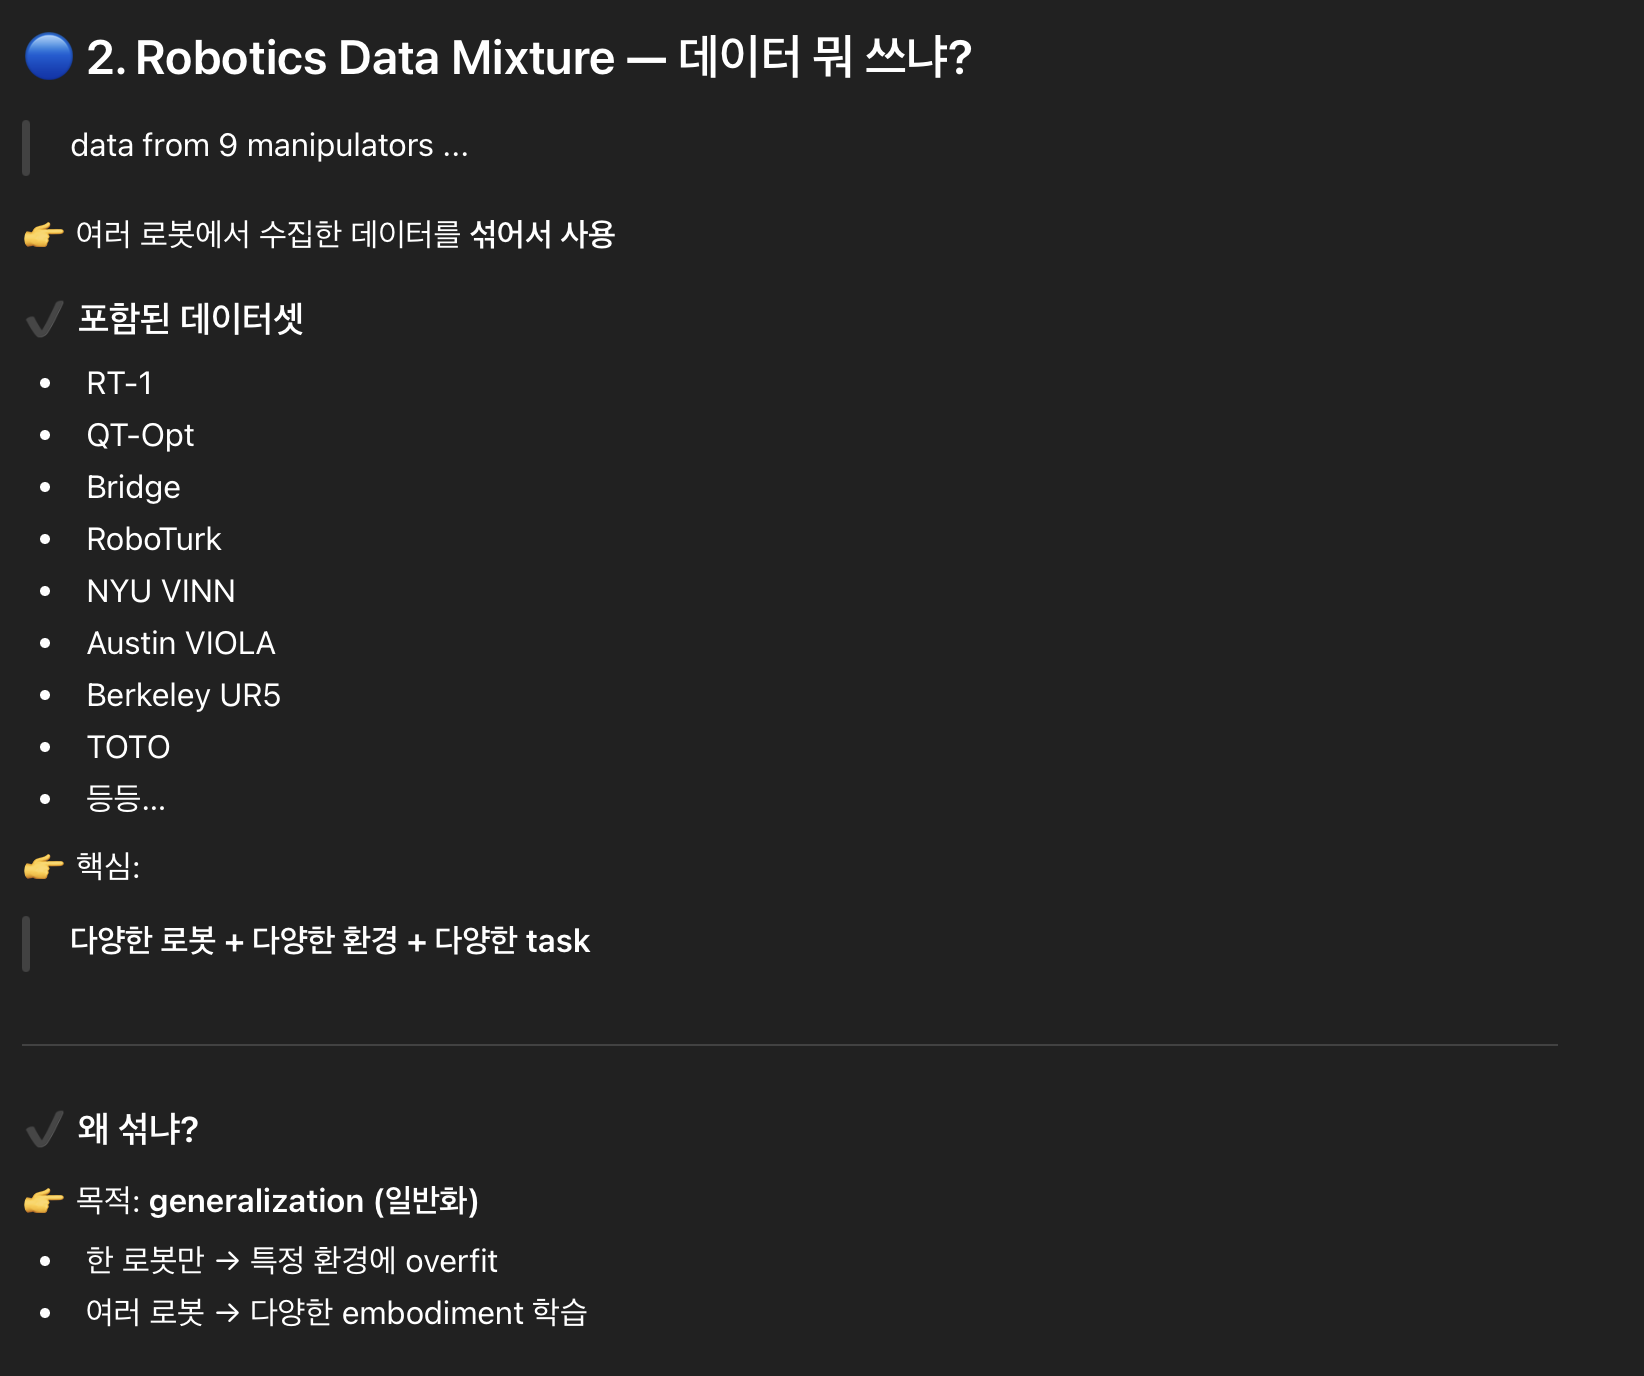
우리는 다양한 데이터로 사전학습된 비전 및 언어 모델의 일반화 능력에서 영감을 받아, 범용 로봇 정책을 학습하기 위해서는 X-embodiment training즉 여러 로봇 플랫폼으로부터 수집된 데이터를 활용해야 한다는 관점을 취한다. 개별 로봇 데이터셋은 작을 수 있지만, 이를 통합하면 다양한 환경과 로봇을 포괄하는 더 넓은 데이터 커버리지를 얻을 수 있다.
이러한 배경을 바탕으로, 본 논문은 두 가지 목표를 가진다:
- 여러 로봇과 환경에서 수집된 데이터로 학습된 정책이 긍정적 전이 효과를 통해, 각 환경별 데이터로만 학습된 정책보다 더 나은 성능을 보이는지 평가
- 향후 X-embodiment 모델 연구를 위해 대규모 로봇 데이터셋을 구축
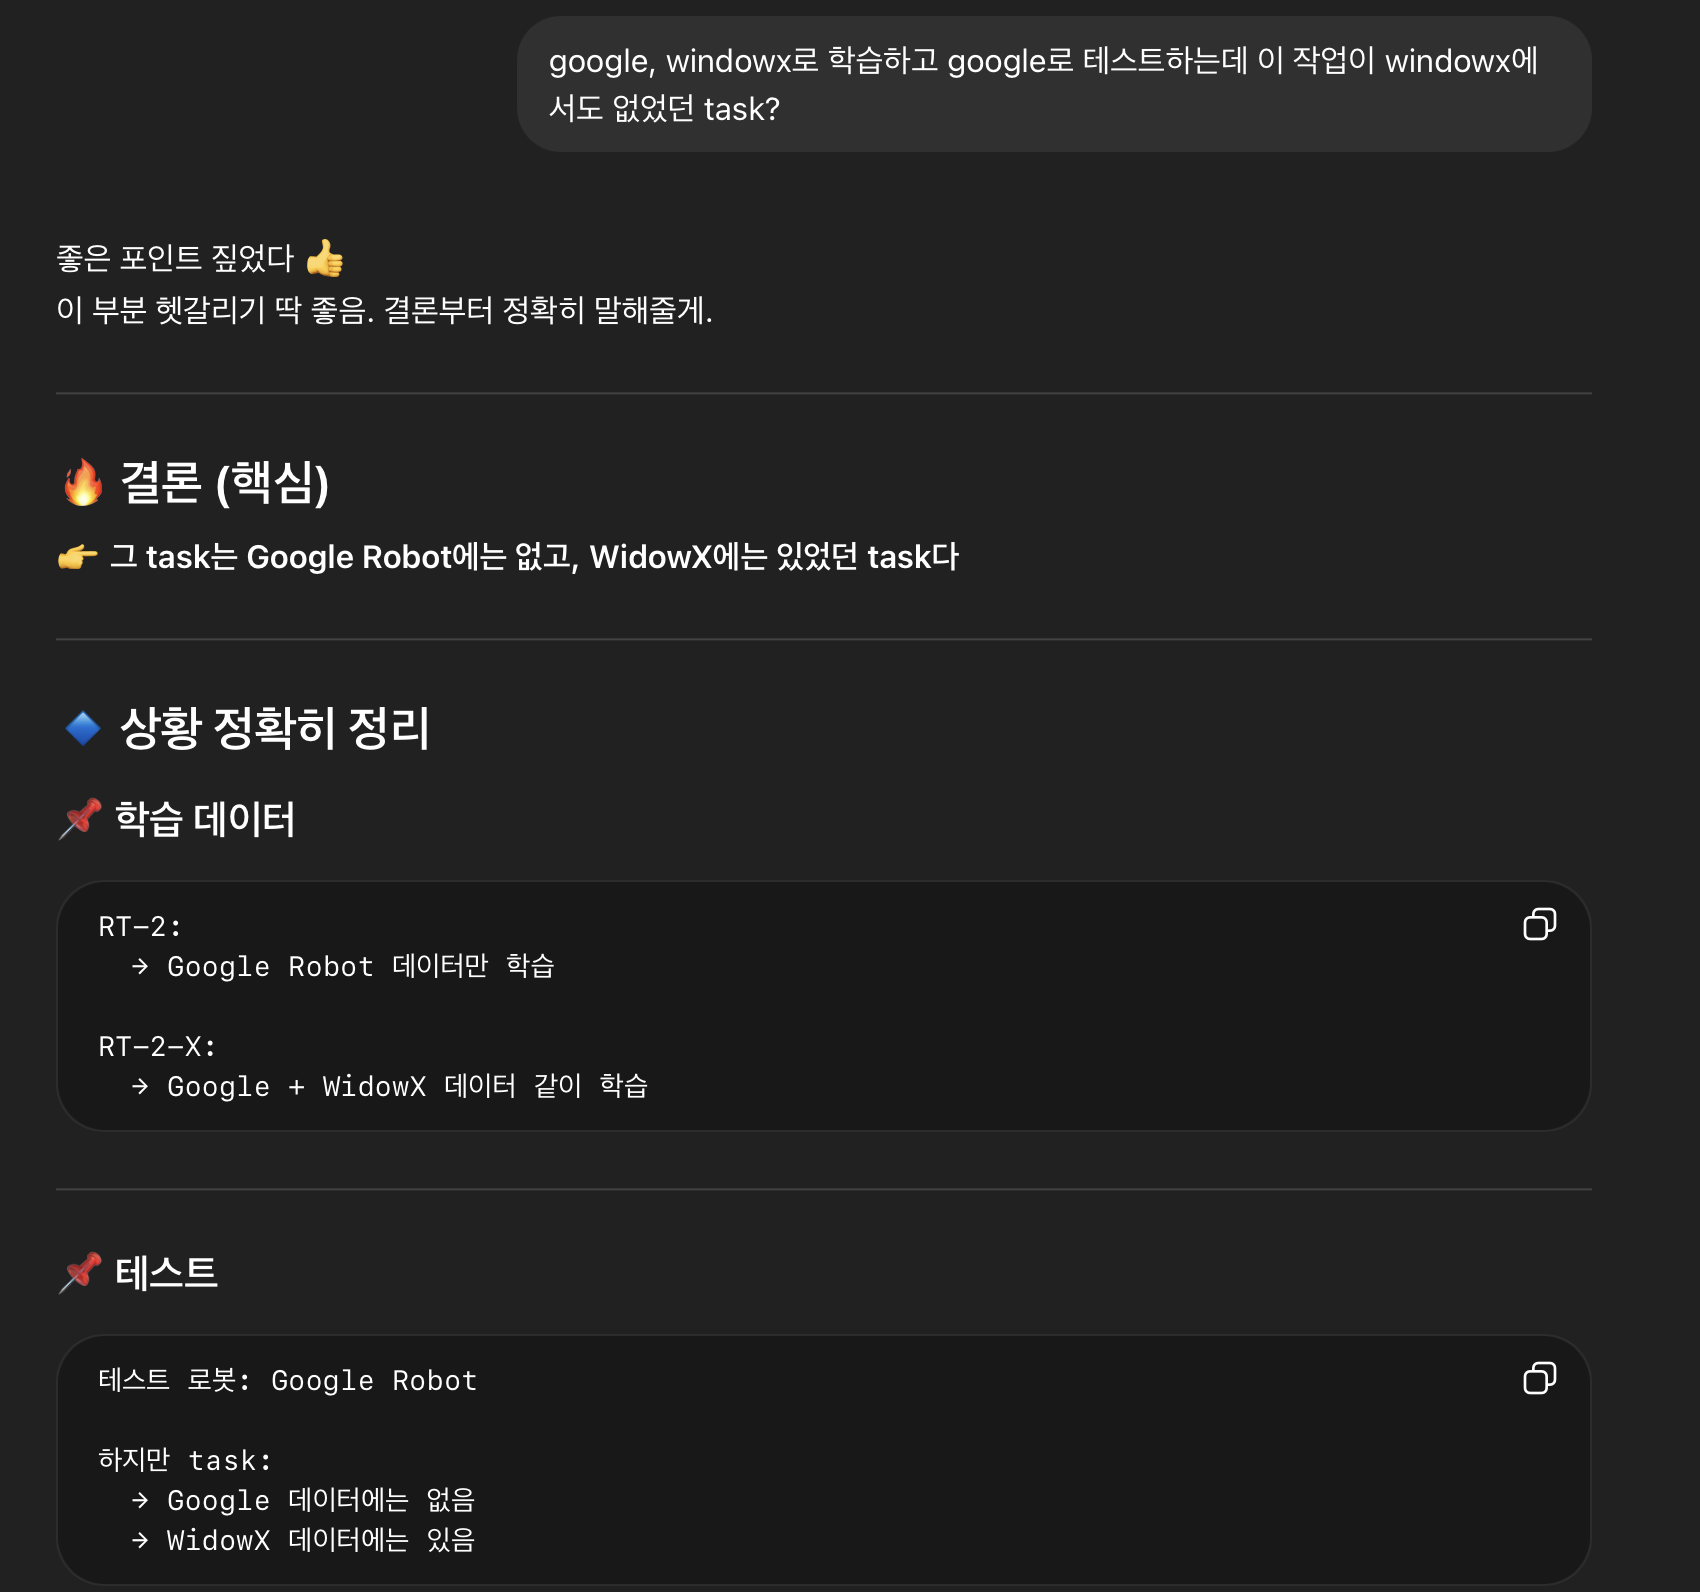
본 논문에서는 로봇 조작 작업을 대상으로 연구를 수행한다. 첫 번째 목표를 위해, 최소한의 수정으로도 기존 로봇 학습 방법들이 X-embodiment 데이터를 활용해 성능을 향상시킬 수 있음을 실험적으로 보여준다. 구체적으로, RT-1과 RT-2 모델을 9개의 서로 다른 로봇 매니퓰레이터에서 학습시키고, 이를 통합한 RT-X 모델이 평가 도메인에서만 학습된 정책보다 더 나은 일반화 성능과 새로운 능력을 보임을 확인하였다.
두 번째 목표를 위해, 우리는 Open X-Embodiment(OXE) 저장소를 제공한다. 이 저장소는 21개 기관에서 수집된 22종의 로봇 데이터셋을 포함하며, 오픈소스 도구와 함께 제공되어 연구자들이 X-embodiment 모델을 쉽게 연구할 수 있도록 지원한다. 우리의 목표는 새로운 아키텍처를 제안하는 것이 아니라, 데이터와 모델, 도구를 함께 제공하여 X-embodiment 로봇 학습 연구를 활성화하는 것이다.
2. Related Work
Transfer across embodiments
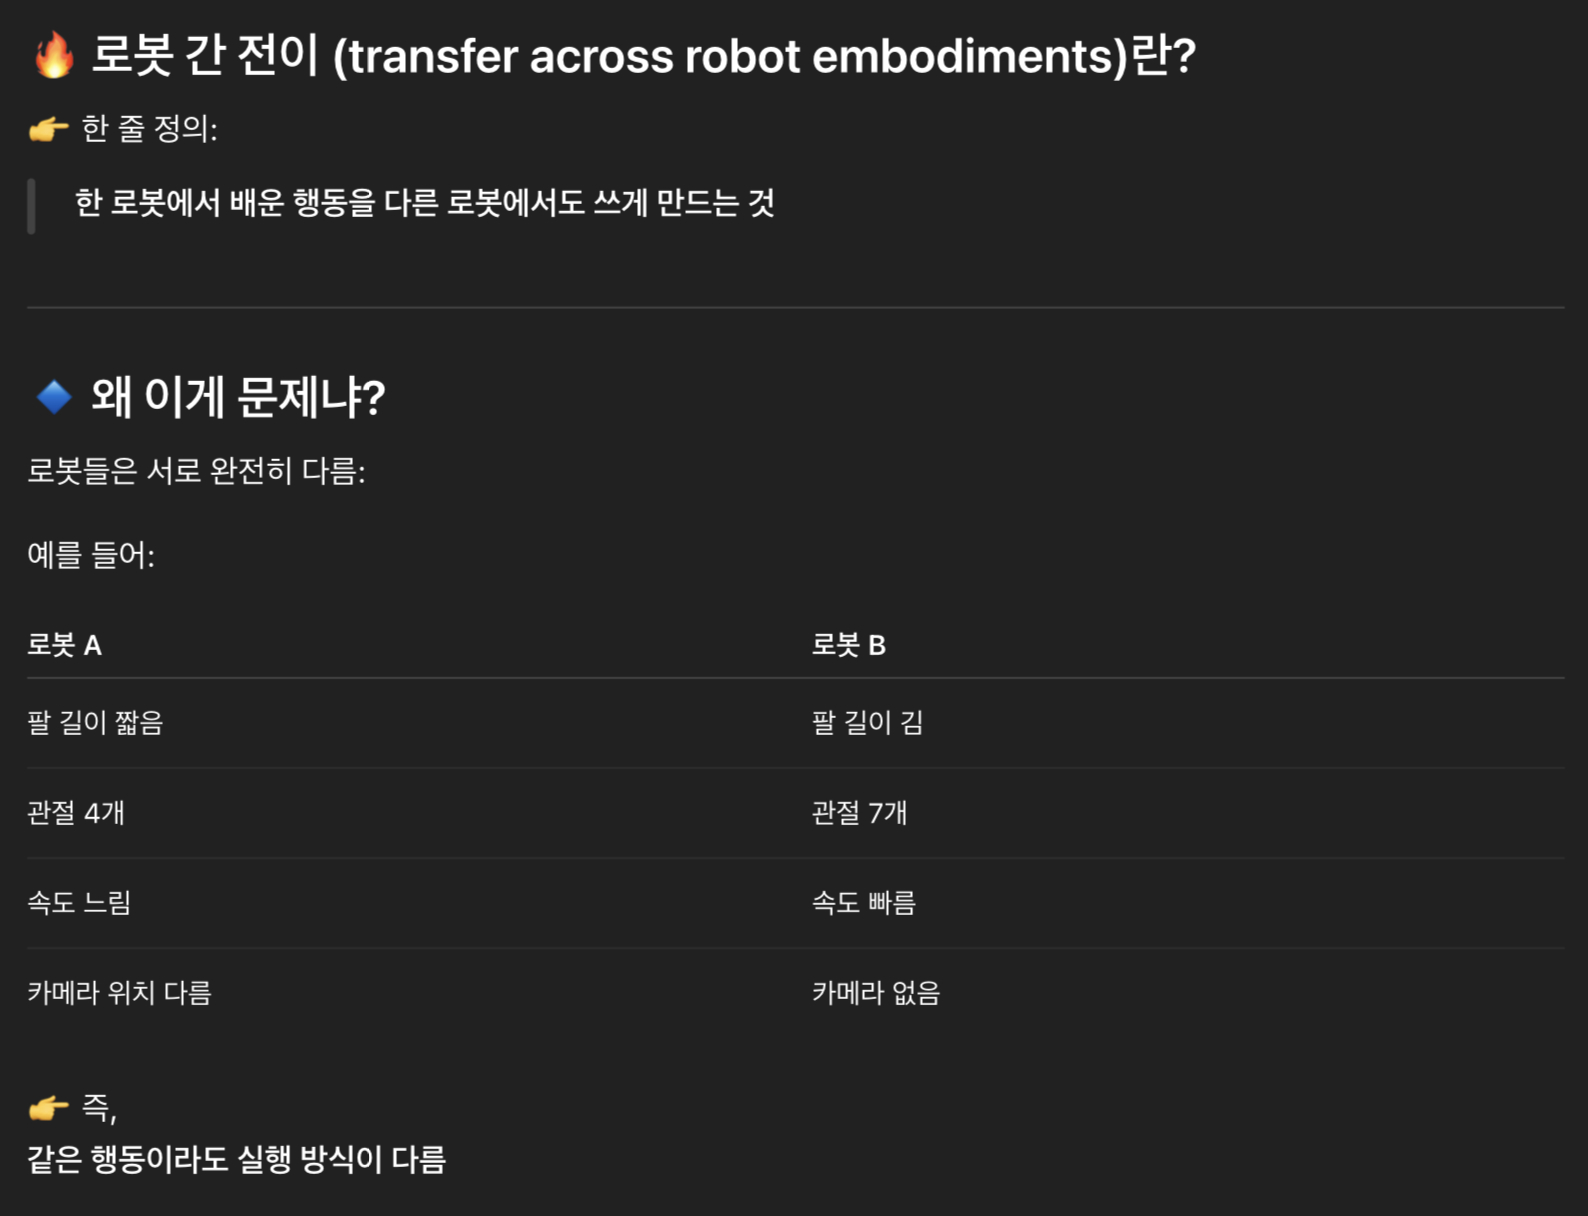
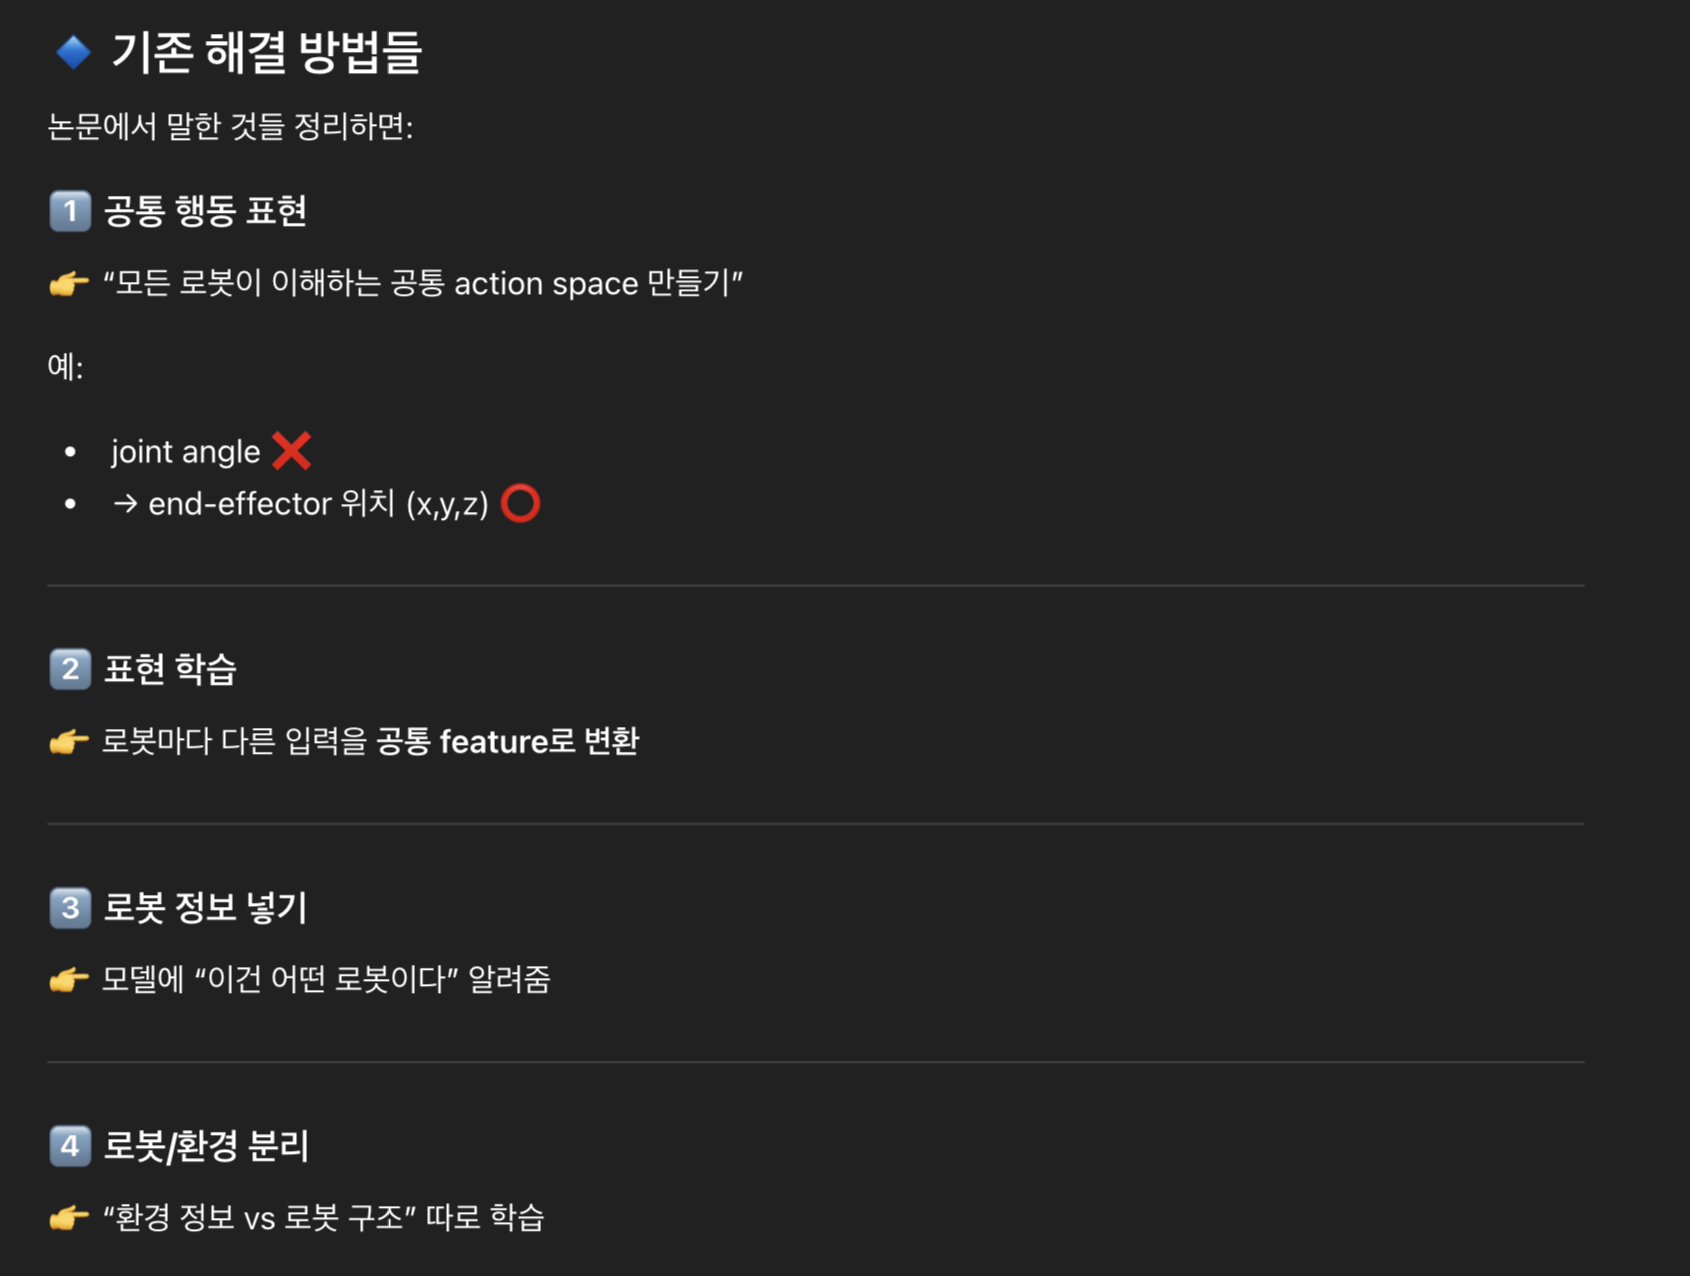
예를 들어:
- 공통된 행동 표현(shared action representations) [14, 30]
- 표현 학습 목표(representation learning objectives)를 포함하는 방법 [17, 26]
- 로봇의 형태 정보에 맞게 정책을 적응시키는 방법 [11, 15, 18, 30, 31]
- 로봇 표현과 환경 표현을 분리하는 방법 [24]
등이 있다.
A 행동 (A 전용) ↓ A → 공통 표현 (translation) ↓ 공통 표현 (robot-independent) ↓ 공통 → B (translation) ↓ B 행동 (B 전용)
기존 연구들은 또한 transformer 모델을 활용하여 **다중 형태(X-embodiment) 학습 [27]과 전이 [25, 29, 32]의 초기 성과를 보여주었다.
우리 연구는 이러한 접근과 보완적인 구조와 분석을 제시하며, 특히 다중 형태 전이와 웹 규모 사전학습(web-scale pretraining) 간의 상호작용을 집중적으로 분석한다.
또한, 인간과 로봇 간 전이를 다루는 연구들도 비슷하게 형태 차이를 줄이기 위해
- 서로 다른 도메인 간 변환
- 전이 가능한 표현 학습 [33–43]
등의 기법을 활용한다.
한편, 일부 연구는 문제의 특정 부분에 집중하여
- 전이 가능한 보상 함수 학습 [17, 44–48]
- 목표(goal) 학습 [49, 50]
- 동역학 모델 [51]
- 인간 비디오 데이터로부터 시각 표현 학습 [52–59]
등을 연구하기도 한다.
하지만 이러한 대부분의 기존 연구들과 달리, 우리는 형태 차이를 줄이기 위한 별도의 메커니즘 없이도 다중 형태 데이터(X-embodiment data) 위에서 정책을 직접 학습하고, 그 데이터를 활용하여 긍정적인 전이 효과를 얻을 수 있음을 보인다.
대규모 로봇 학습 데이터셋 (Large-scale robot learning datasets)
로봇 학습 커뮤니티에서는 다양한 오픈소스 데이터셋을 구축해왔다. 예를 들어:
- 그립(grasping) 데이터 [60–71]
- 밀기(pushing) 상호작용 데이터 [23, 72–74]
- 객체 및 모델 데이터셋 [75–85]
- 원격조작(teleoperation) 시연 데이터 [8, 86–95]
등이 있다.
그러나 RoboNet [23]을 제외하면, 이러한 데이터셋들은 대부분 같은 종류의 로봇 데이터만 포함한다.
반면 우리는 여러 서로 다른 형태의 로봇 데이터를 포함하는 데이터에 집중한다.
우리의 데이터 저장소(repository)의 목표는 기존 연구를 보완하는 것으로, 여러 기존 데이터셋을 처리하고 통합하여 하나의 표준화된 저장소(Open X-Embodiment)로 구축하는 것이다.
이 저장소는 로봇 학습 데이터셋을 의미 있고 유용한 방식으로 공유하는 방법을 보여준다.
언어 조건 기반 로봇 학습 (Language-conditioned robot learning)
기존 연구들은 로봇이나 에이전트가 자연어 명령을 이해하고 수행할 수 있도록 하는 것을 목표로 해왔다 [96–101].
이는 주로 언어 조건 정책(language-conditioned policies)을 학습하는 방식으로 이루어진다 [8, 40, 45, 102–106].
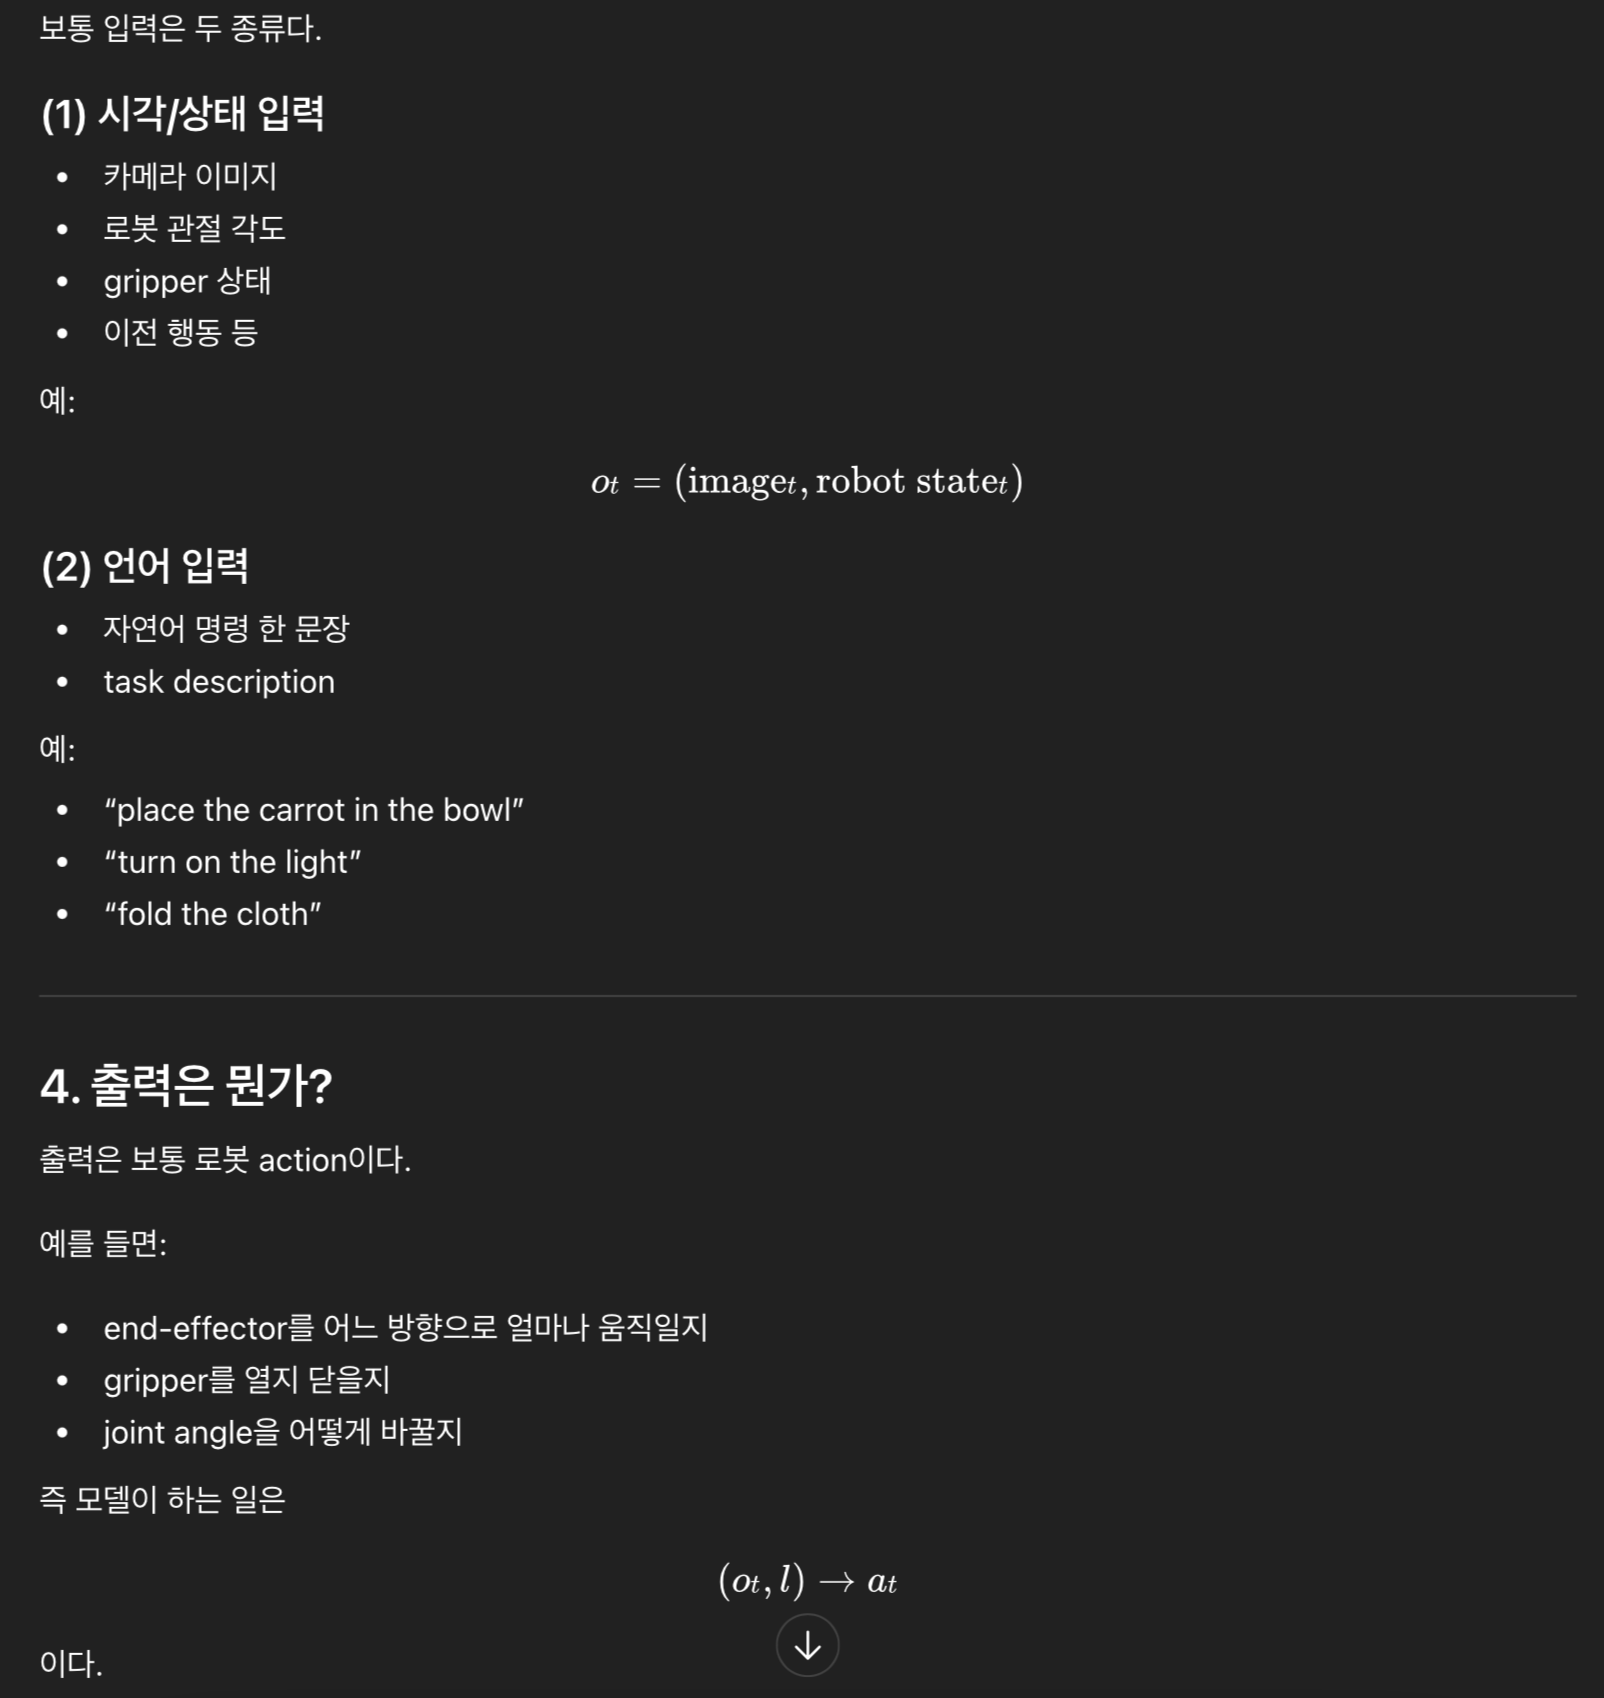
우리 역시 많은 기존 연구와 마찬가지로 모방학습(imitation learning)을 통해 언어 조건 정책을 학습한다.
하지만 우리는 대규모 다중 형태 시연 데이터(multi-embodiment demonstration data)를 사용한다는 점에서 차별화된다.
또한, 이전 연구들처럼
- 사전학습된 언어 임베딩 [8, 40, 45, 103, 107–112]
- 사전학습된 비전-언어 모델 [9, 113–115]
을 활용하는 동시에,
우리 실험에서는 이 두 가지 형태의 사전학습을 모두 연구하며, 특히 RT-1 [8]과 RT-2 [9]의 접근 방식을 따른다.
3. THE OPEN X-EMBODIMENT REPOSITORY
우리는 Open X-Embodiment Repository (robotics-transformer-x.github.io)를 소개한다. 이는 대규모 데이터와 함께, X-embodiment 로봇 학습 연구를 위한 사전학습 모델 체크포인트를 포함한 오픈소스 저장소이다.
보다 구체적으로, 우리는 다음과 같은 오픈소스 자원을 커뮤니티에 제공하고 유지한다:
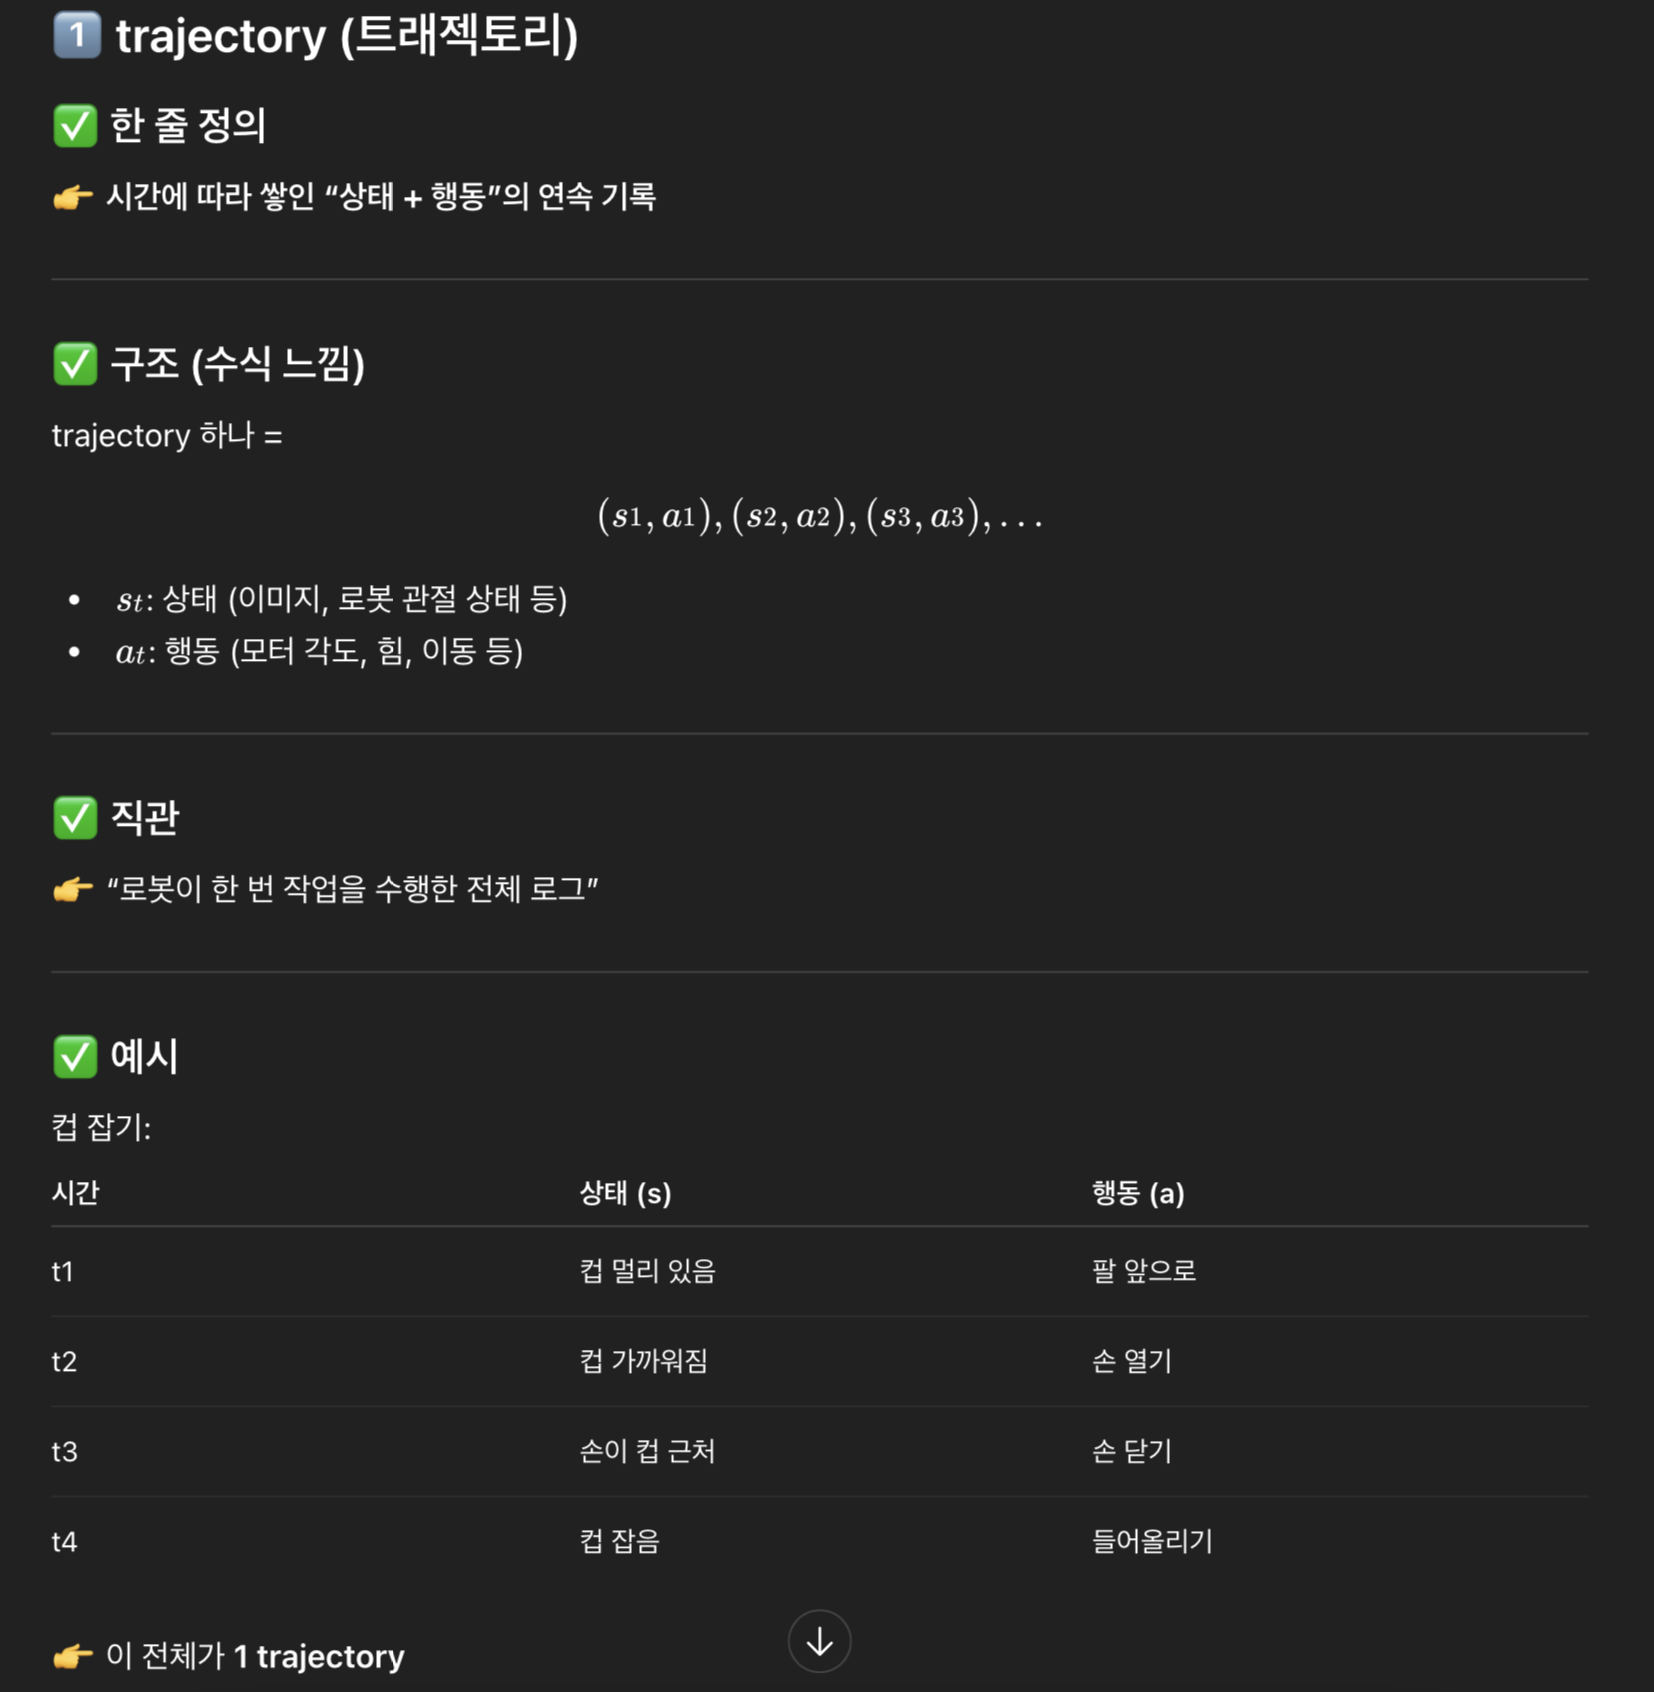
- Open X-Embodiment Dataset: 22개의 서로 다른 로봇 형태(embodiment)에서 수집된 100만 개 이상의 로봇 trajectory를 포함한 데이터셋
- Pre-Trained Checkpoints: 추론(inference)과 파인튜닝에 바로 사용할 수 있는 RT-X 모델 체크포인트 모음
우리는 이러한 자원들이 X-embodiment 로봇 학습의 기반(foundation)이 되기를 기대하지만, 이것은 시작에 불과하다. Open X-Embodiment는 커뮤니티 주도 프로젝트이며, 현재 전 세계 21개 기관이 참여하고 있다. 앞으로 더 많은 참여를 유도하고, 초기 데이터셋을 지속적으로 확장할 계획이다.
이 섹션에서는 데이터셋과 X-embodiment 학습 프레임워크를 요약한 후, 이 데이터셋을 평가하기 위해 사용한 모델들과 실험 결과를 설명한다.
A. The Open X-Embodiment Dataset
A. Open X-Embodiment Dataset
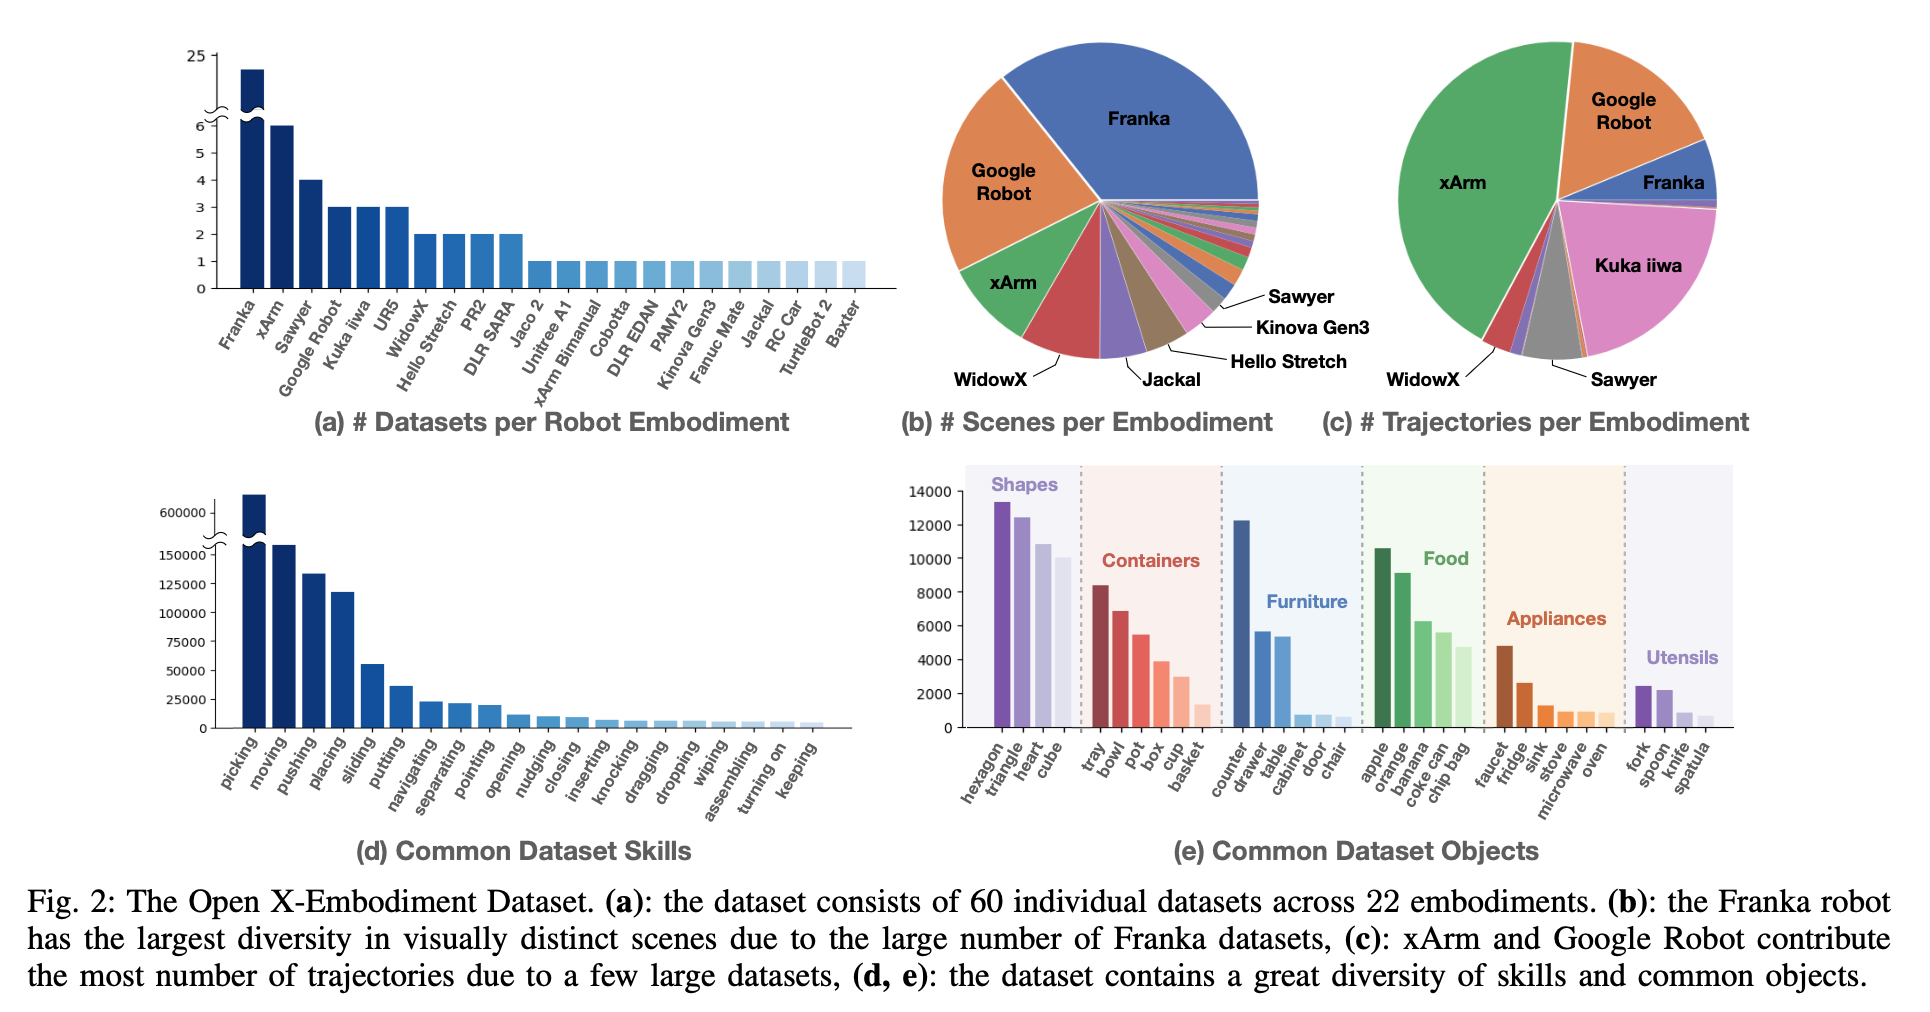
Open X-Embodiment Dataset은 22개의 다양한 로봇 형태를 포함하는 100만 개 이상의 실제 로봇 trajectory로 구성되어 있으며, 단일 로봇 팔부터 양팔 로봇, 그리고 사족 보행 로봇까지 포함한다.
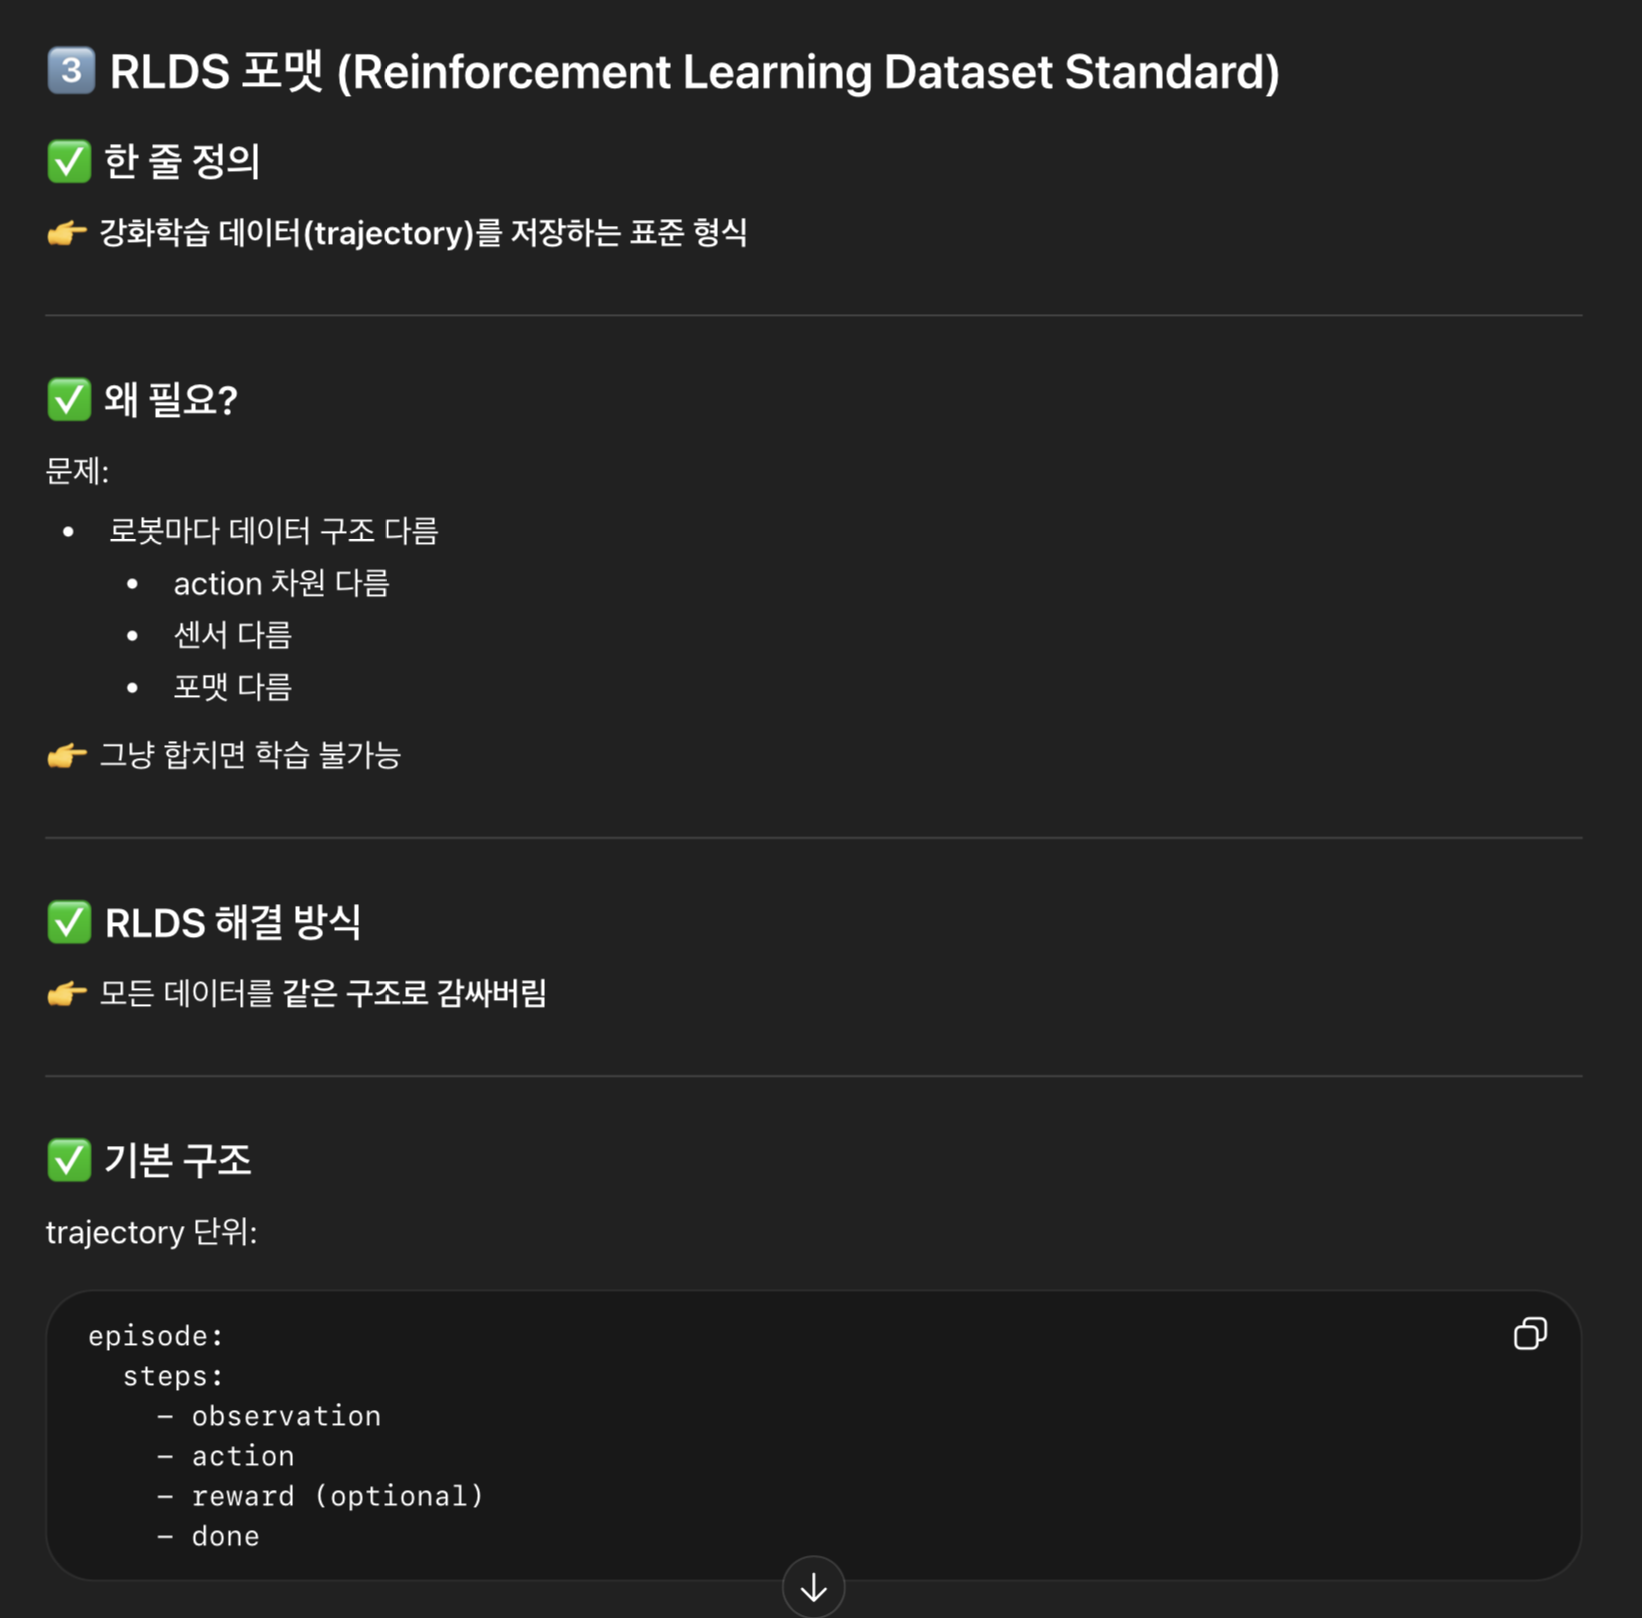
이 데이터셋은 전 세계 34개 연구실에서 수집된 60개의 기존 로봇 데이터셋을 통합(pooling)하고, 이를 일관된 데이터 형식으로 변환하여 구축되었다. → 즉, 서로 다른 실험 데이터를 하나로 통합
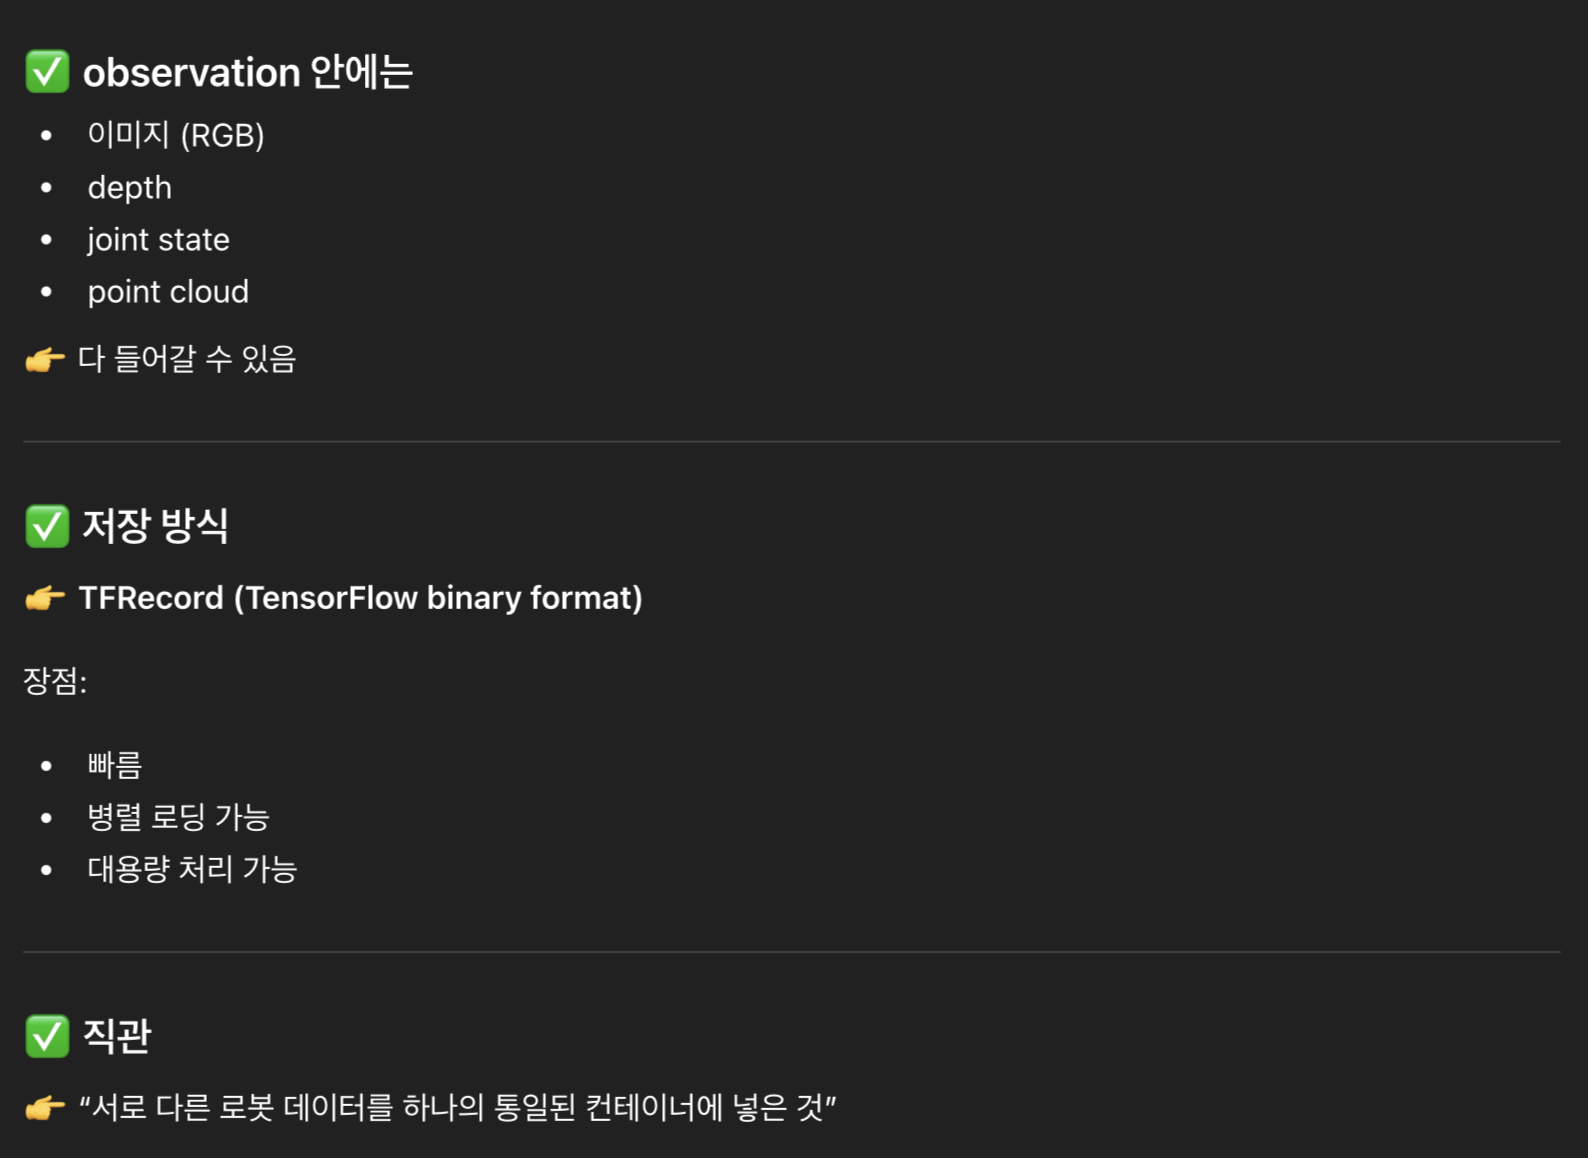
우리는 RLDS 데이터 포맷을 사용하며, 이는 데이터를 직렬화된 TFRecord 파일 형태로 저장한다.
이 포맷은 다음을 지원한다:
- 다양한 action space (로봇마다 다른 제어 방식)
- 다양한 입력 형태 (모달리티)
- RGB 카메라
- depth 카메라
- point cloud
또한 주요 딥러닝 프레임워크에서 병렬 데이터 로딩을 효율적으로 지원한다.
데이터 저장 방식 및 전체 60개 데이터셋에 대한 자세한 내용은 robotics-transformer-x.github.io를 참고하라.
B. Dataset Analysis
4. RT-X DESIGN
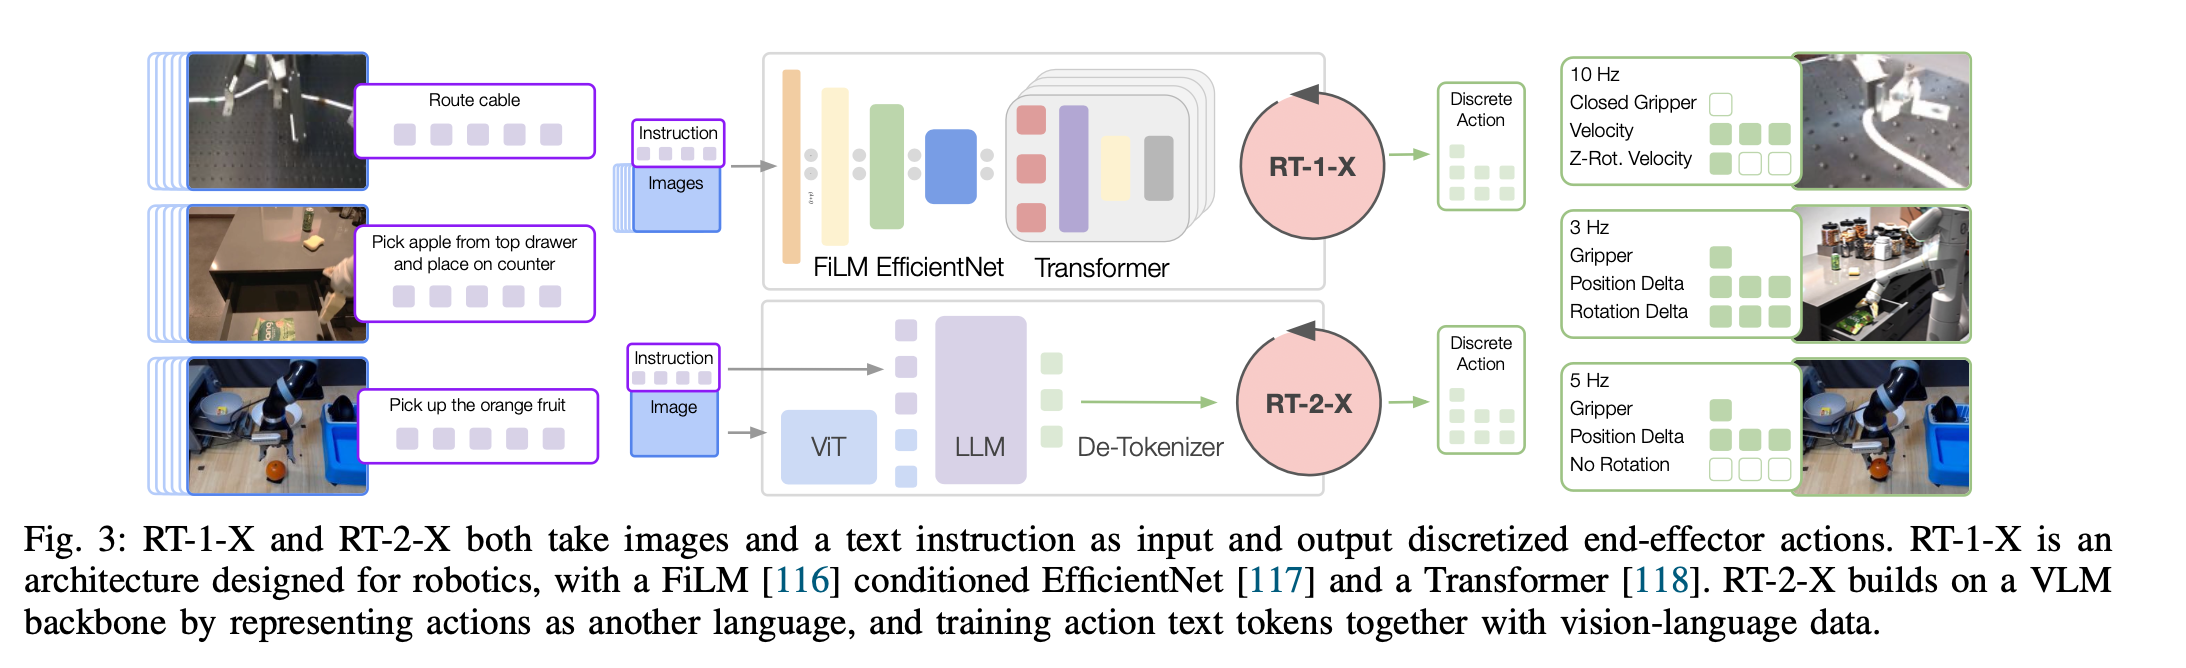
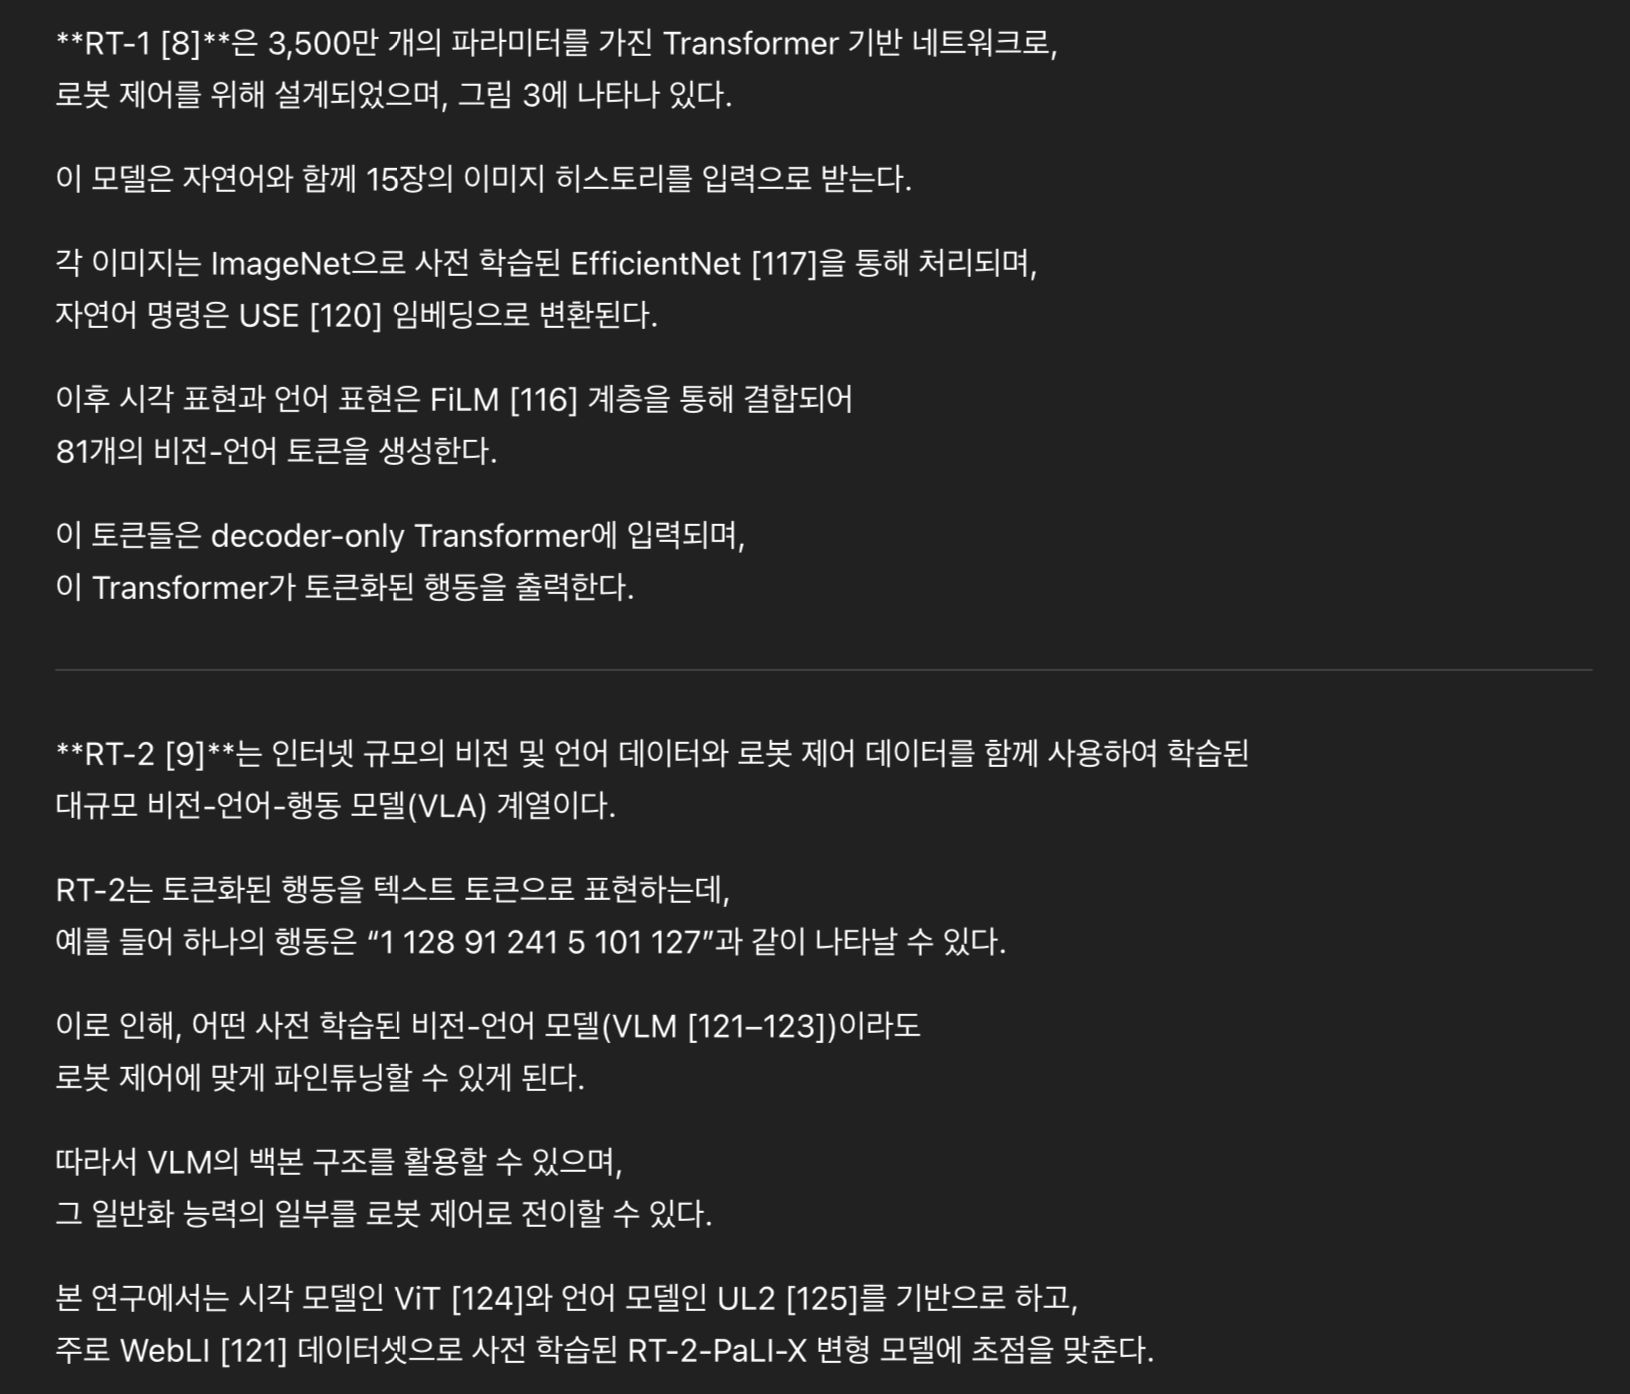
개별 로봇에서 학습된 정책의 성능이 X-embodiment 학습을 통해 얼마나 향상될 수 있는지 평가하기 위해, 우리는 이렇게 크고 이질적인 데이터셋을 효과적으로 활용할 수 있는 충분한 용량의 모델이 필요하다. 이를 위해, 우리의 실험은 최근 제안된 두 가지 Transformer 기반 로봇 정책인 RT-1 [8]과 **RT-2 [9]를 기반으로 한다. 이 섹션에서는 이 모델들의 설계를 간략히 요약하고, 우리의 실험에서 X-embodiment 설정에 맞게 어떻게 변형했는지 설명한다.
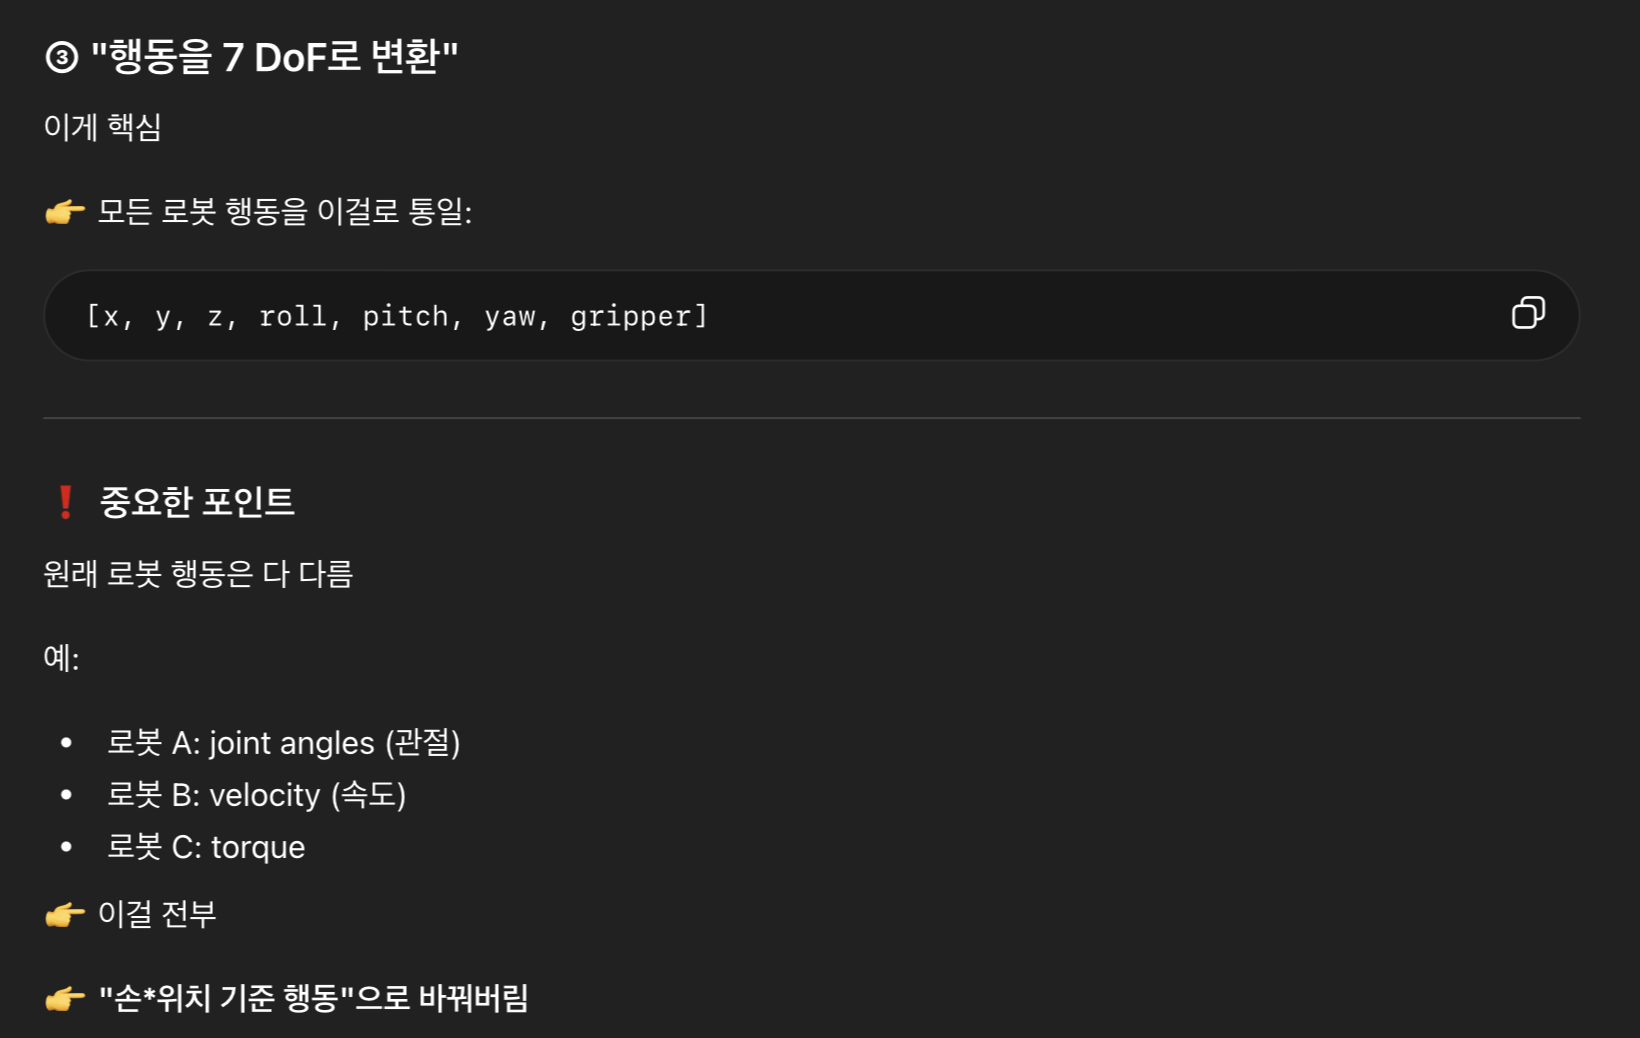
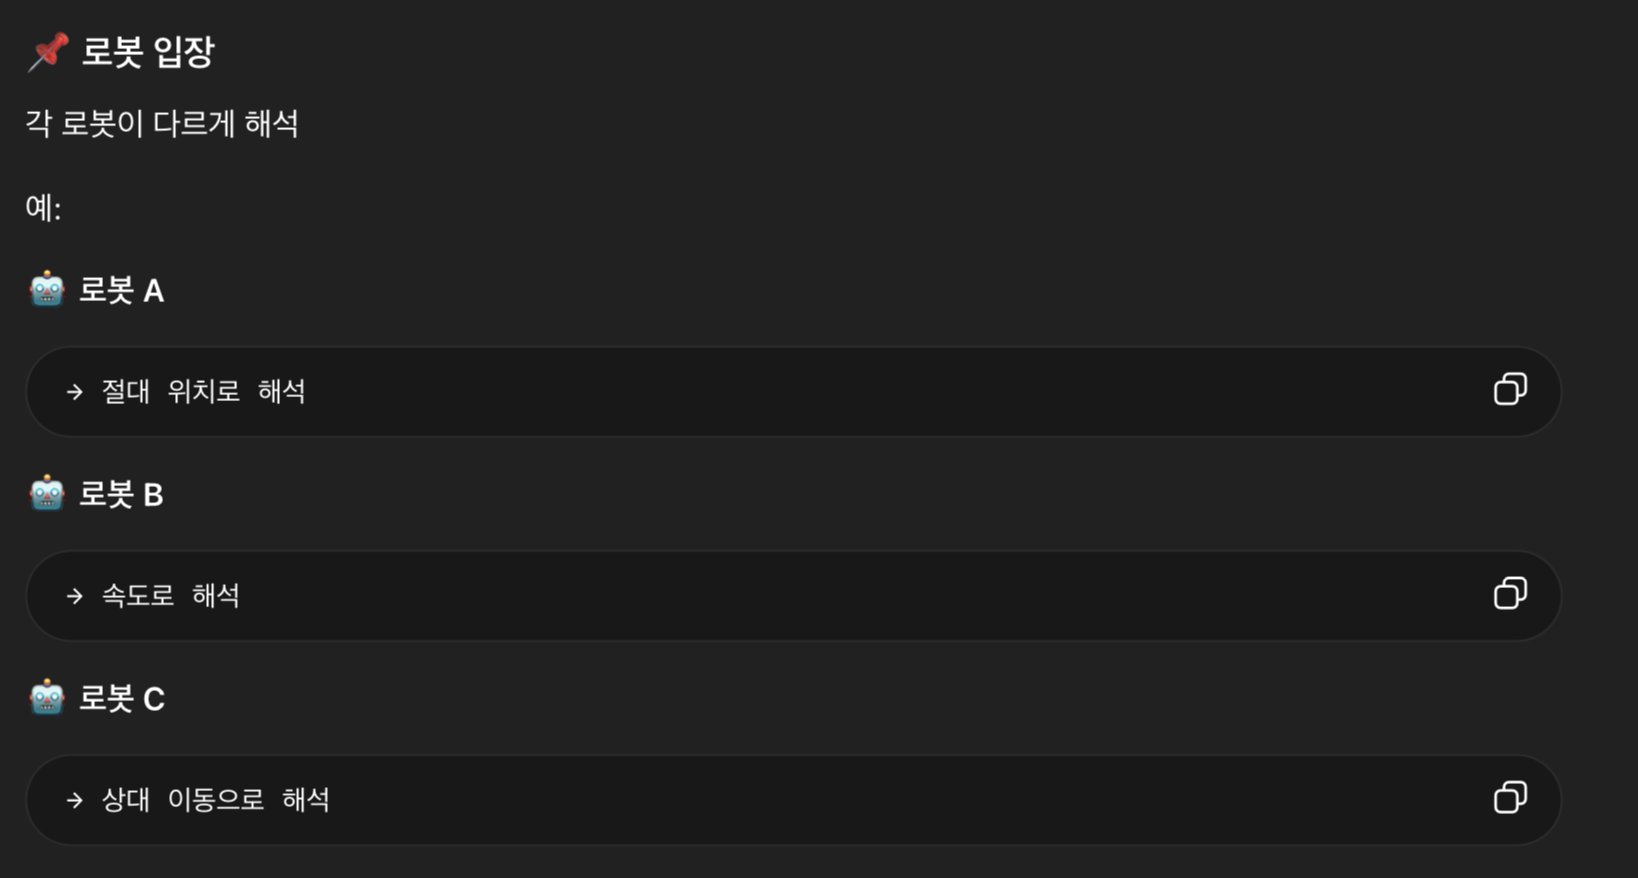
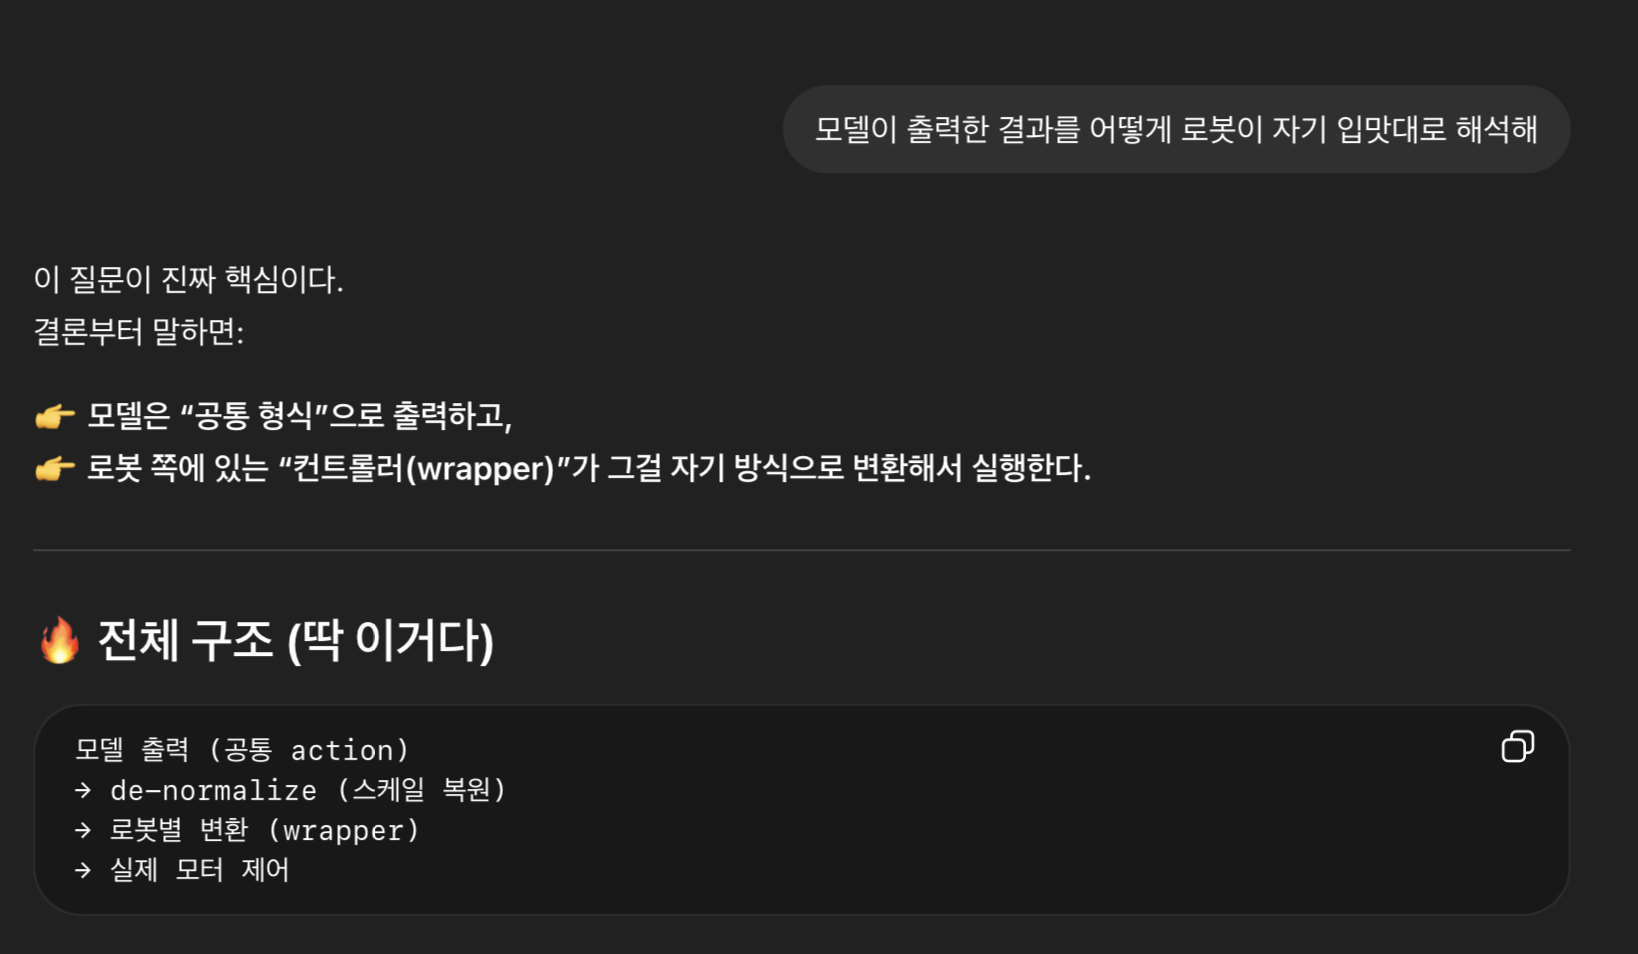
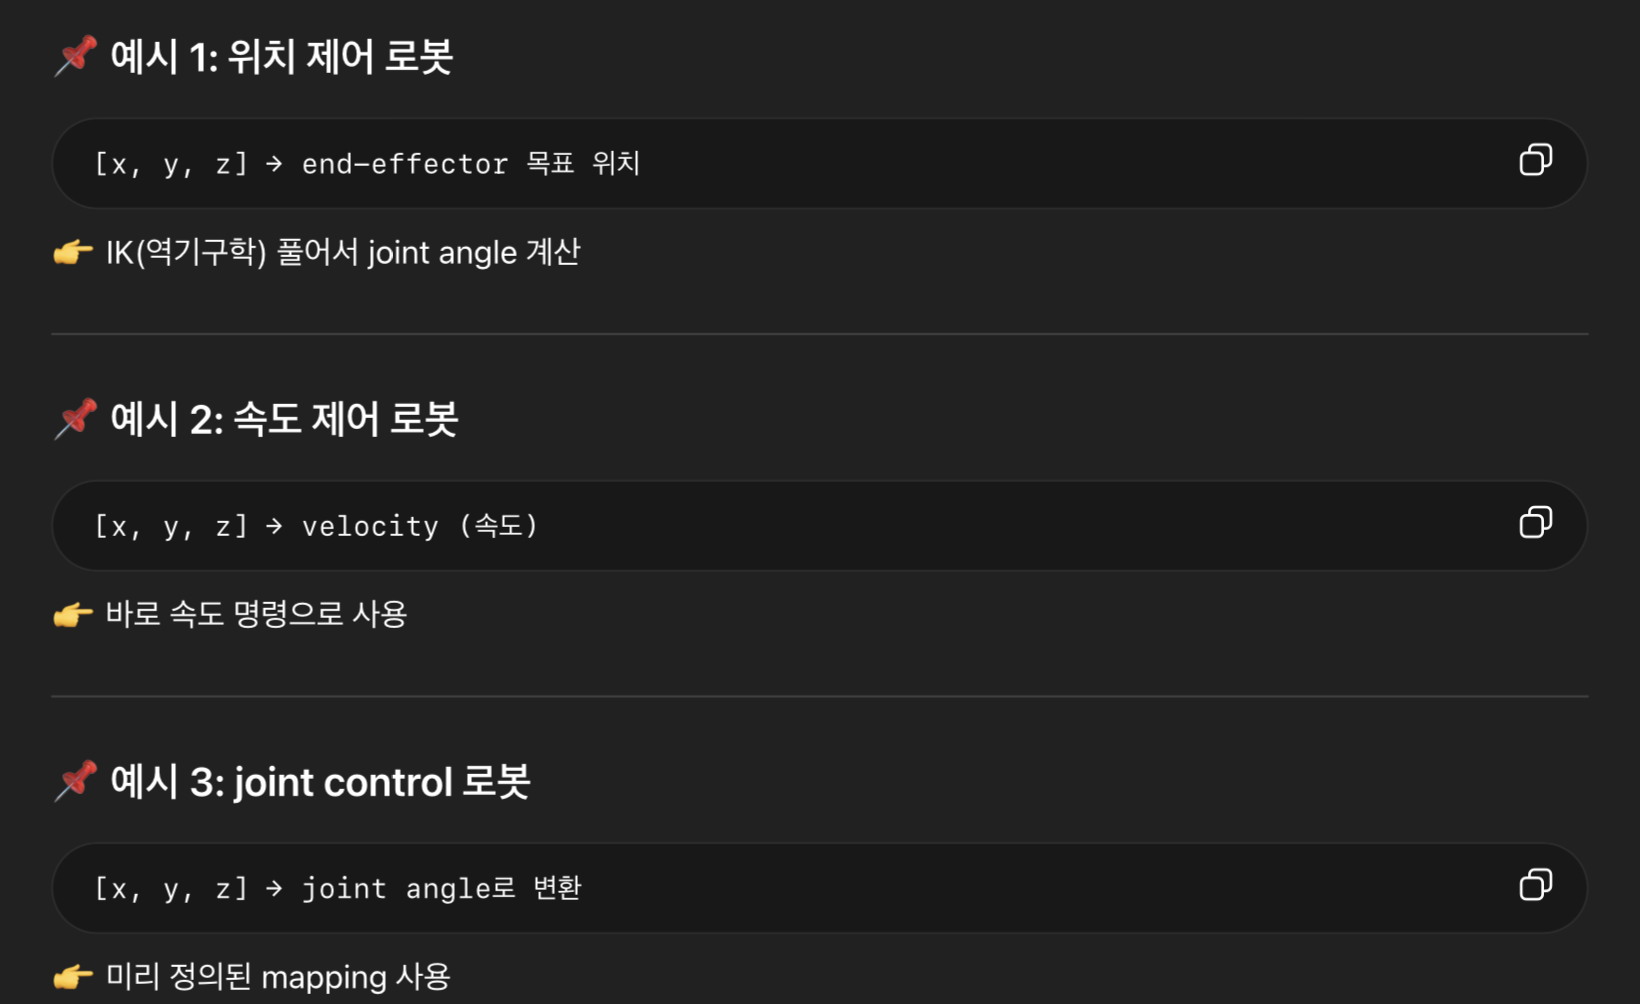
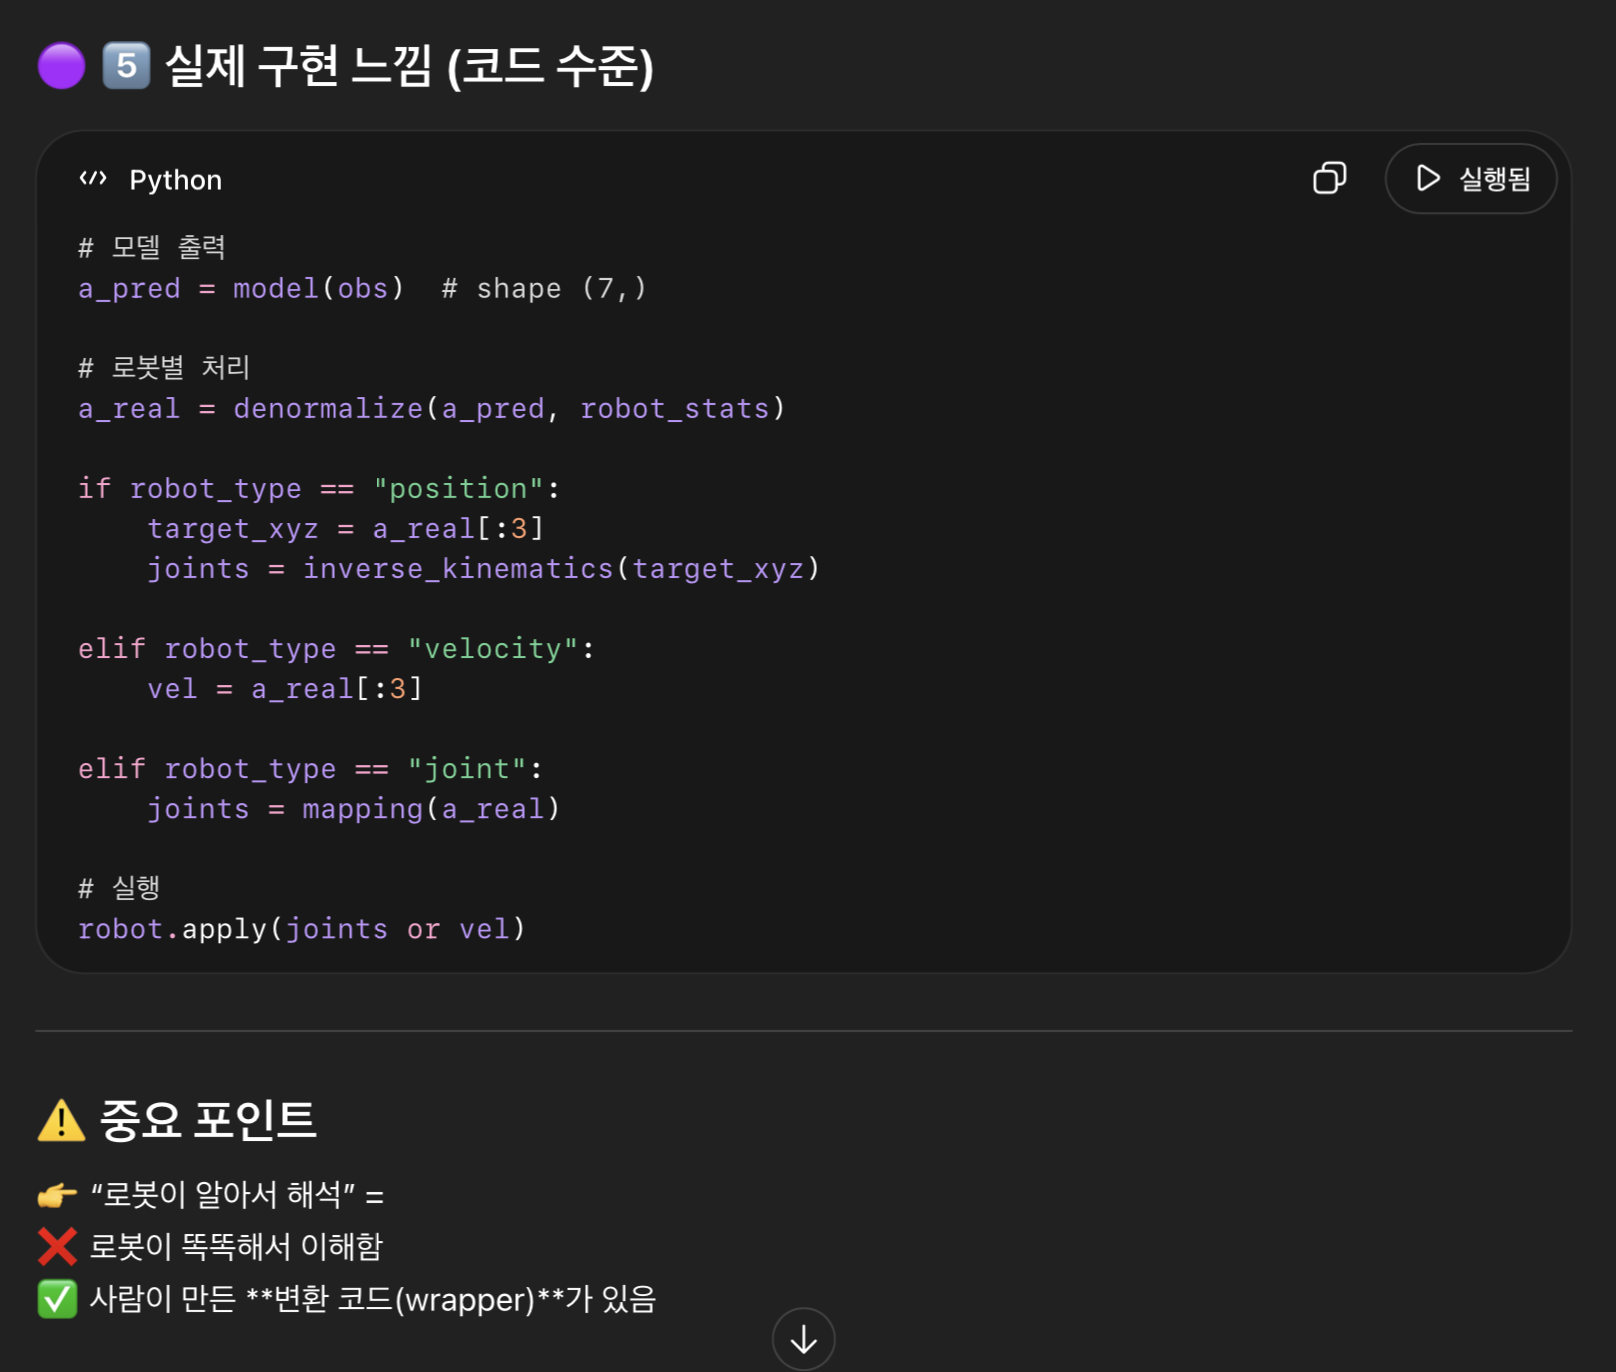
A. Data format consolidation (데이터 형식 통합)
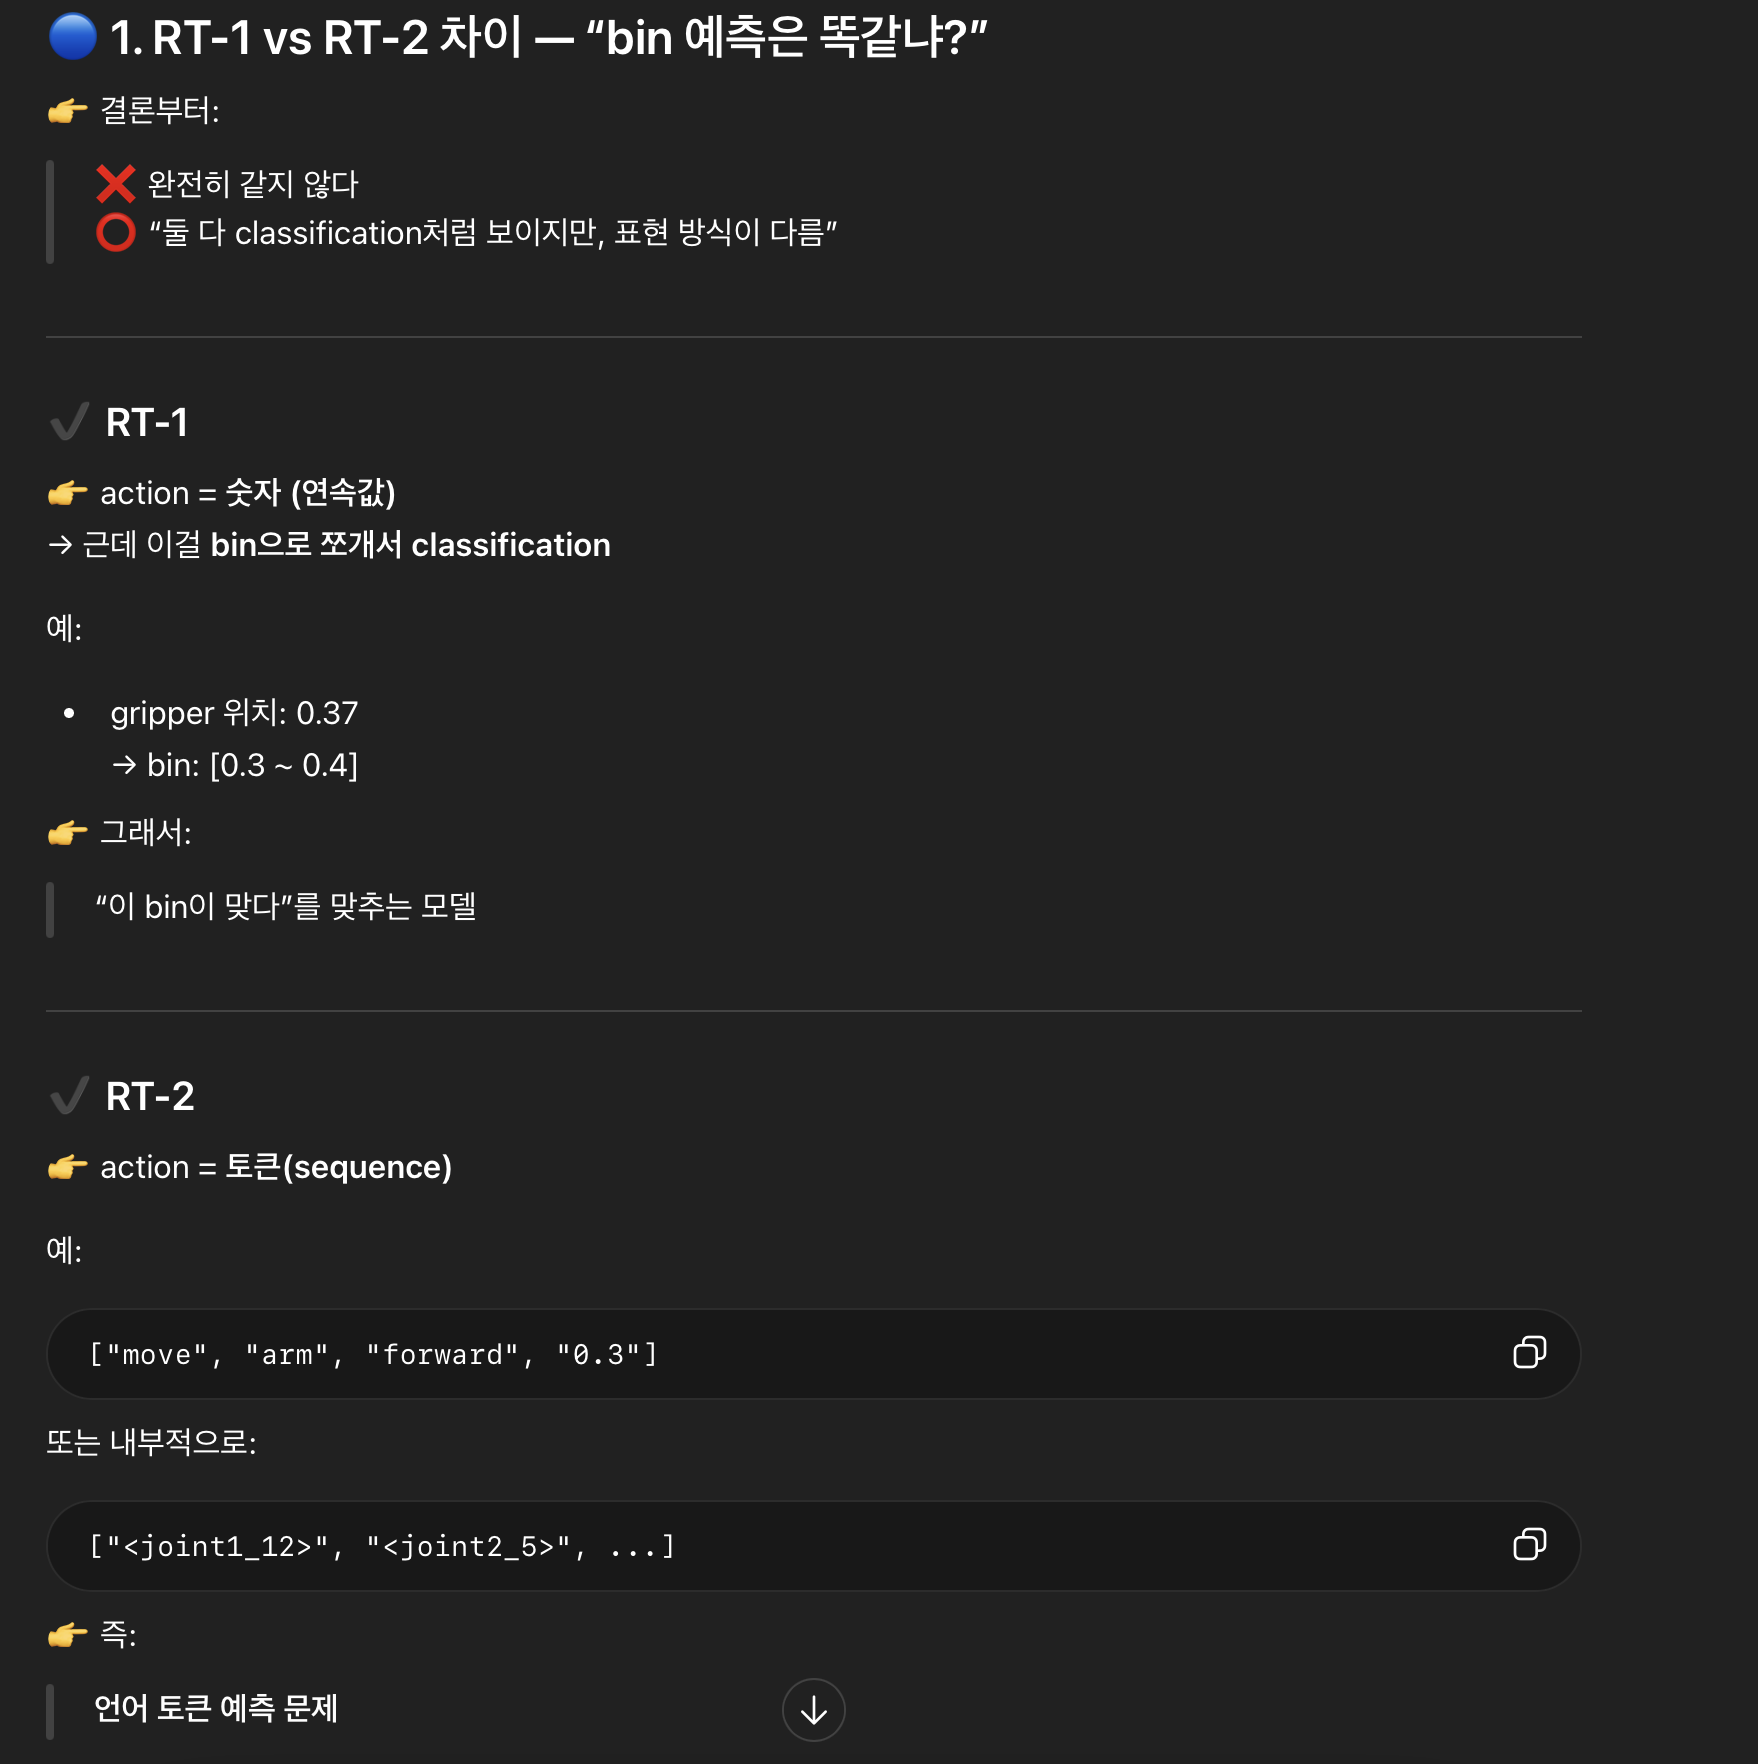
B. Policy architectures
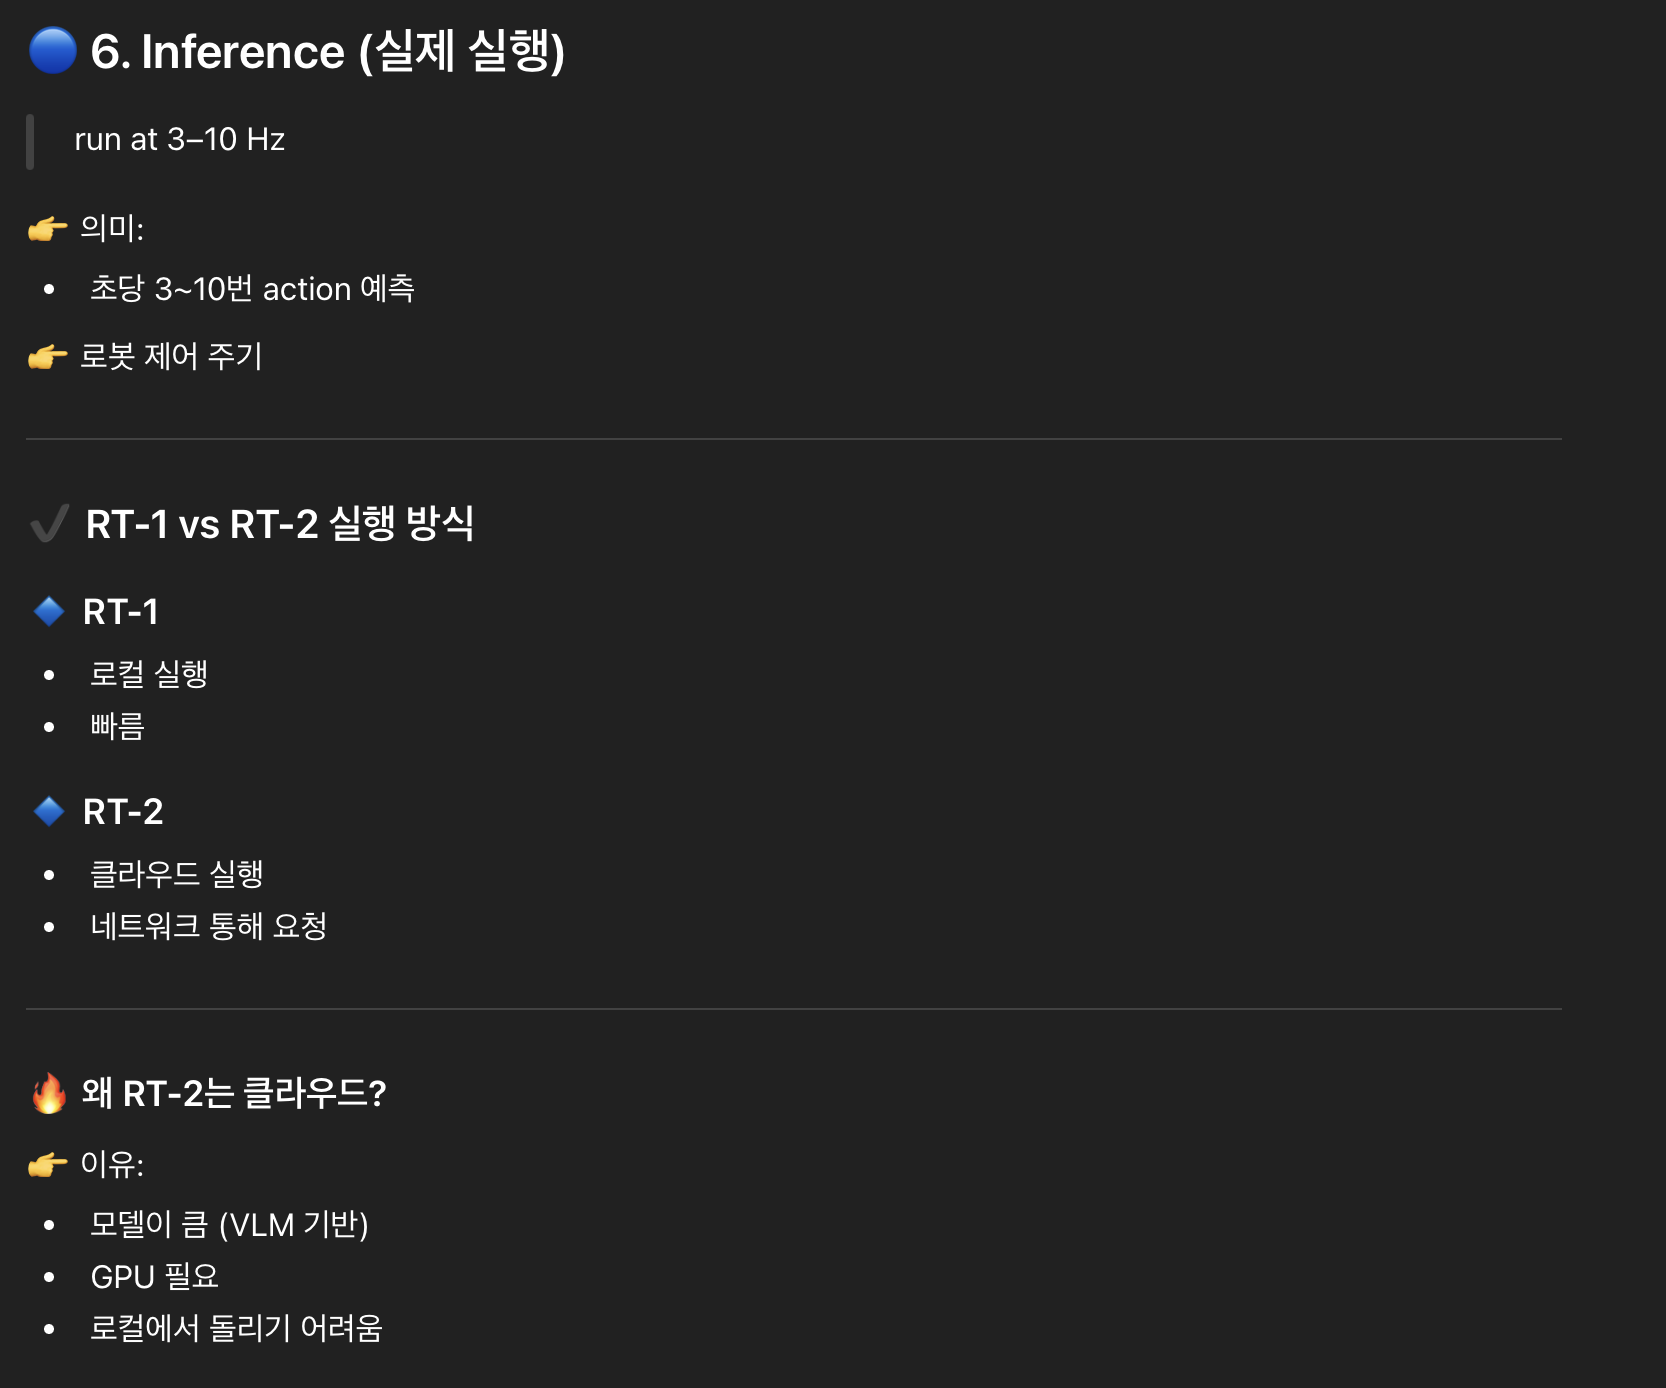
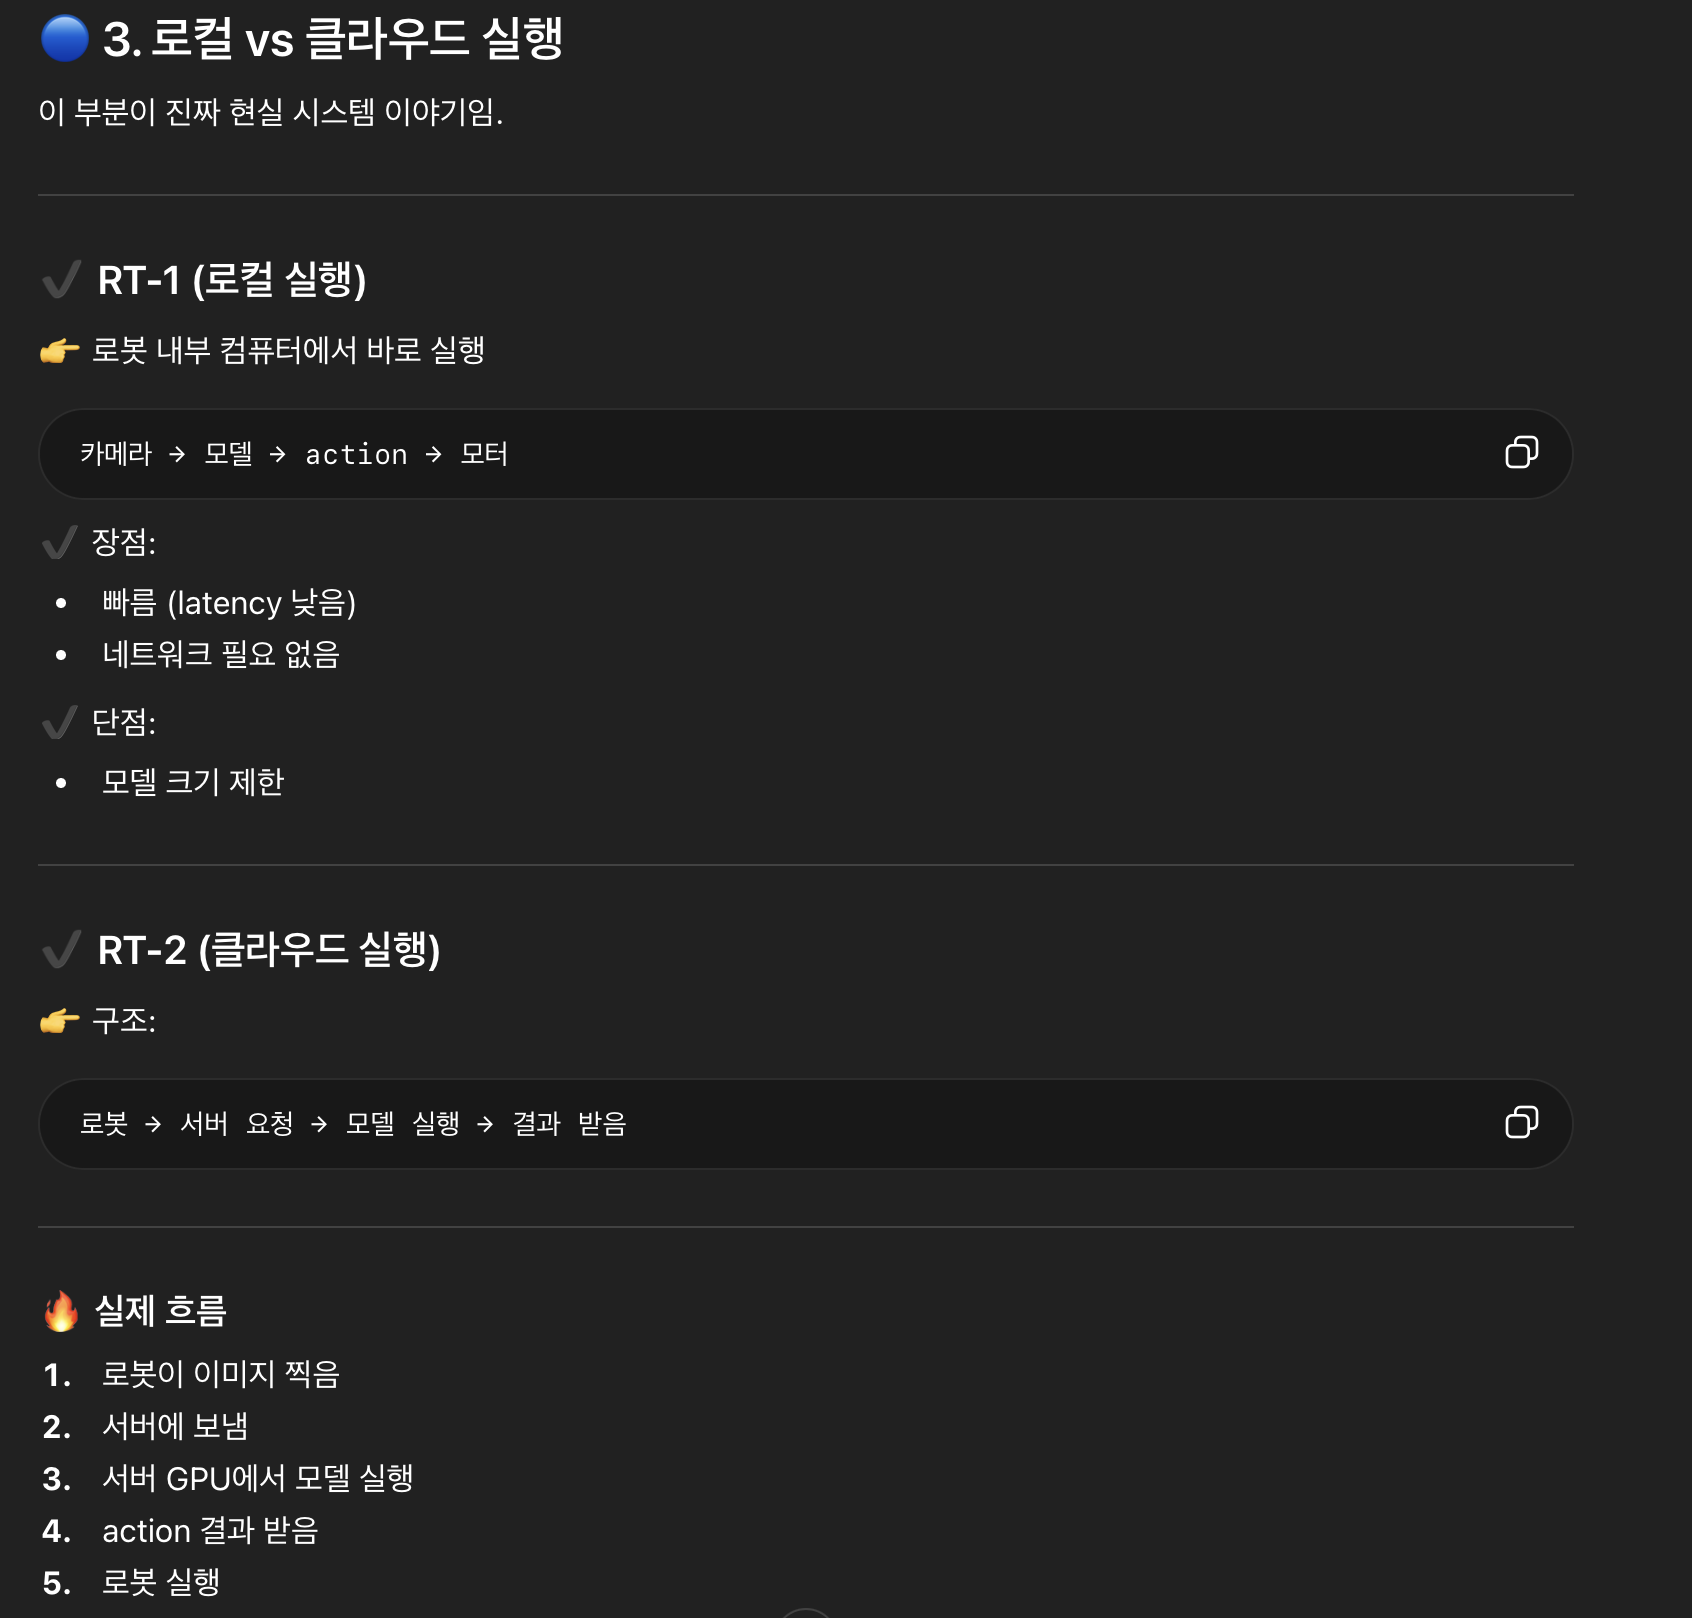
C. Training and inference details
5. EXPERIMENTAL RESULTS
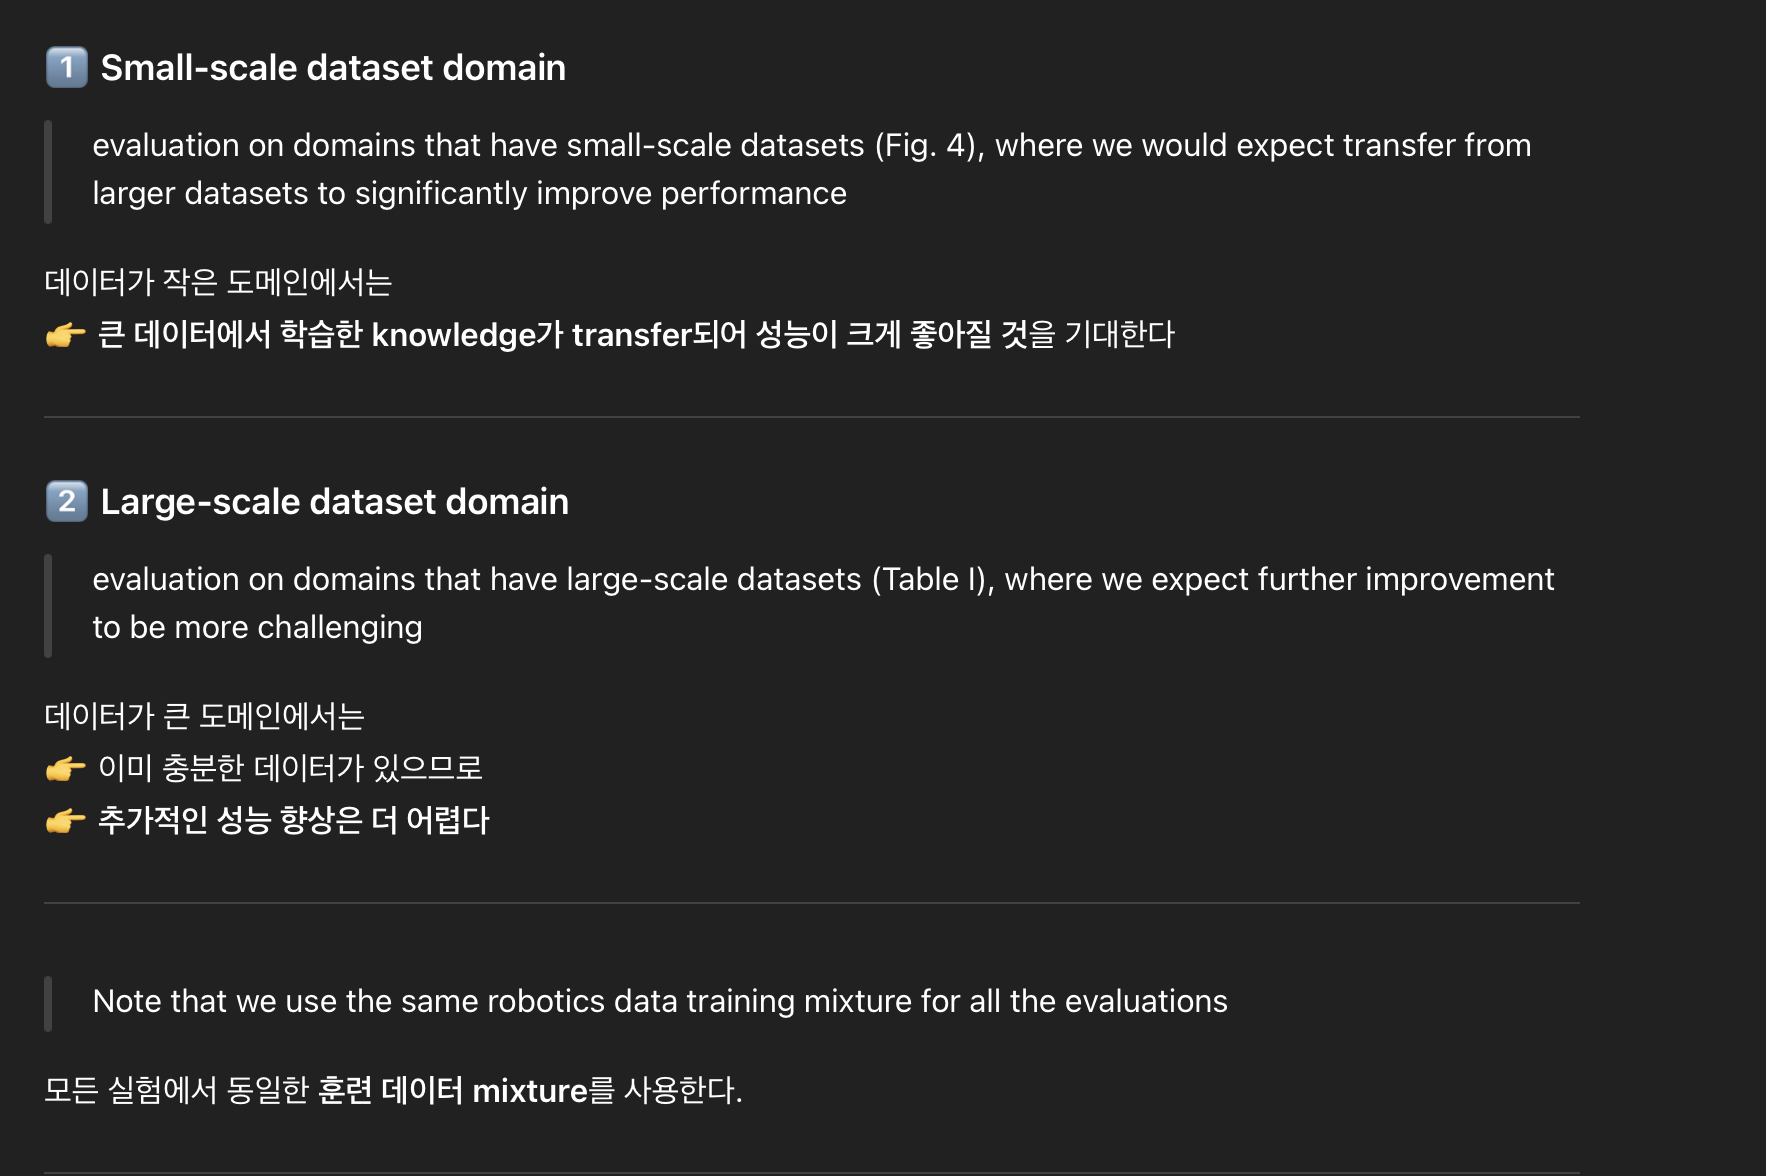
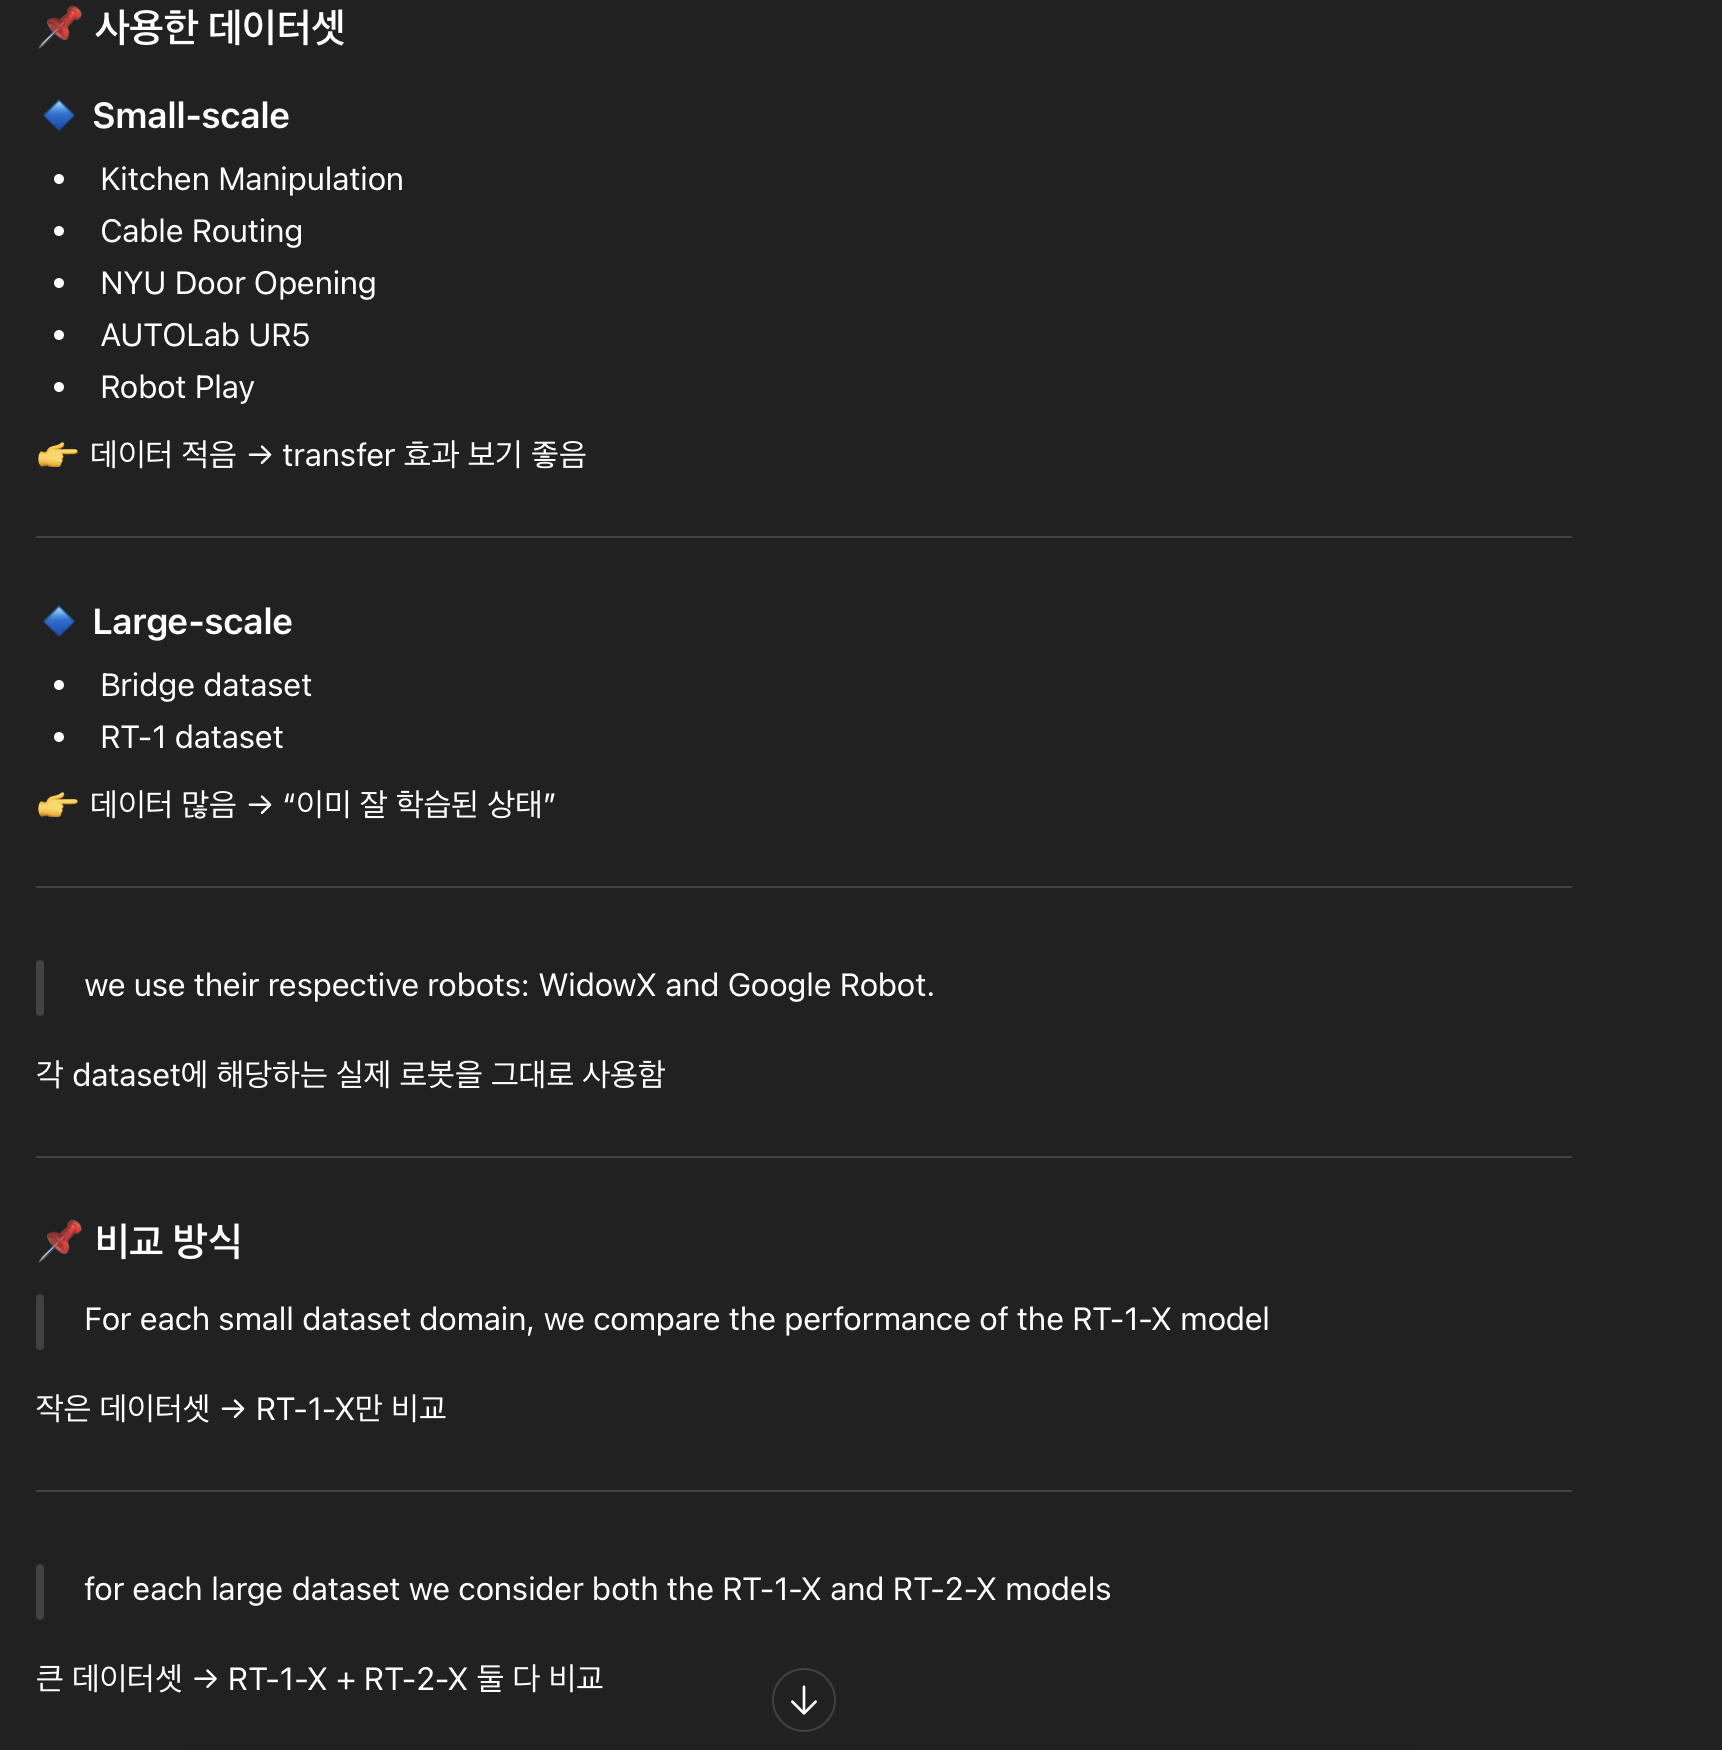
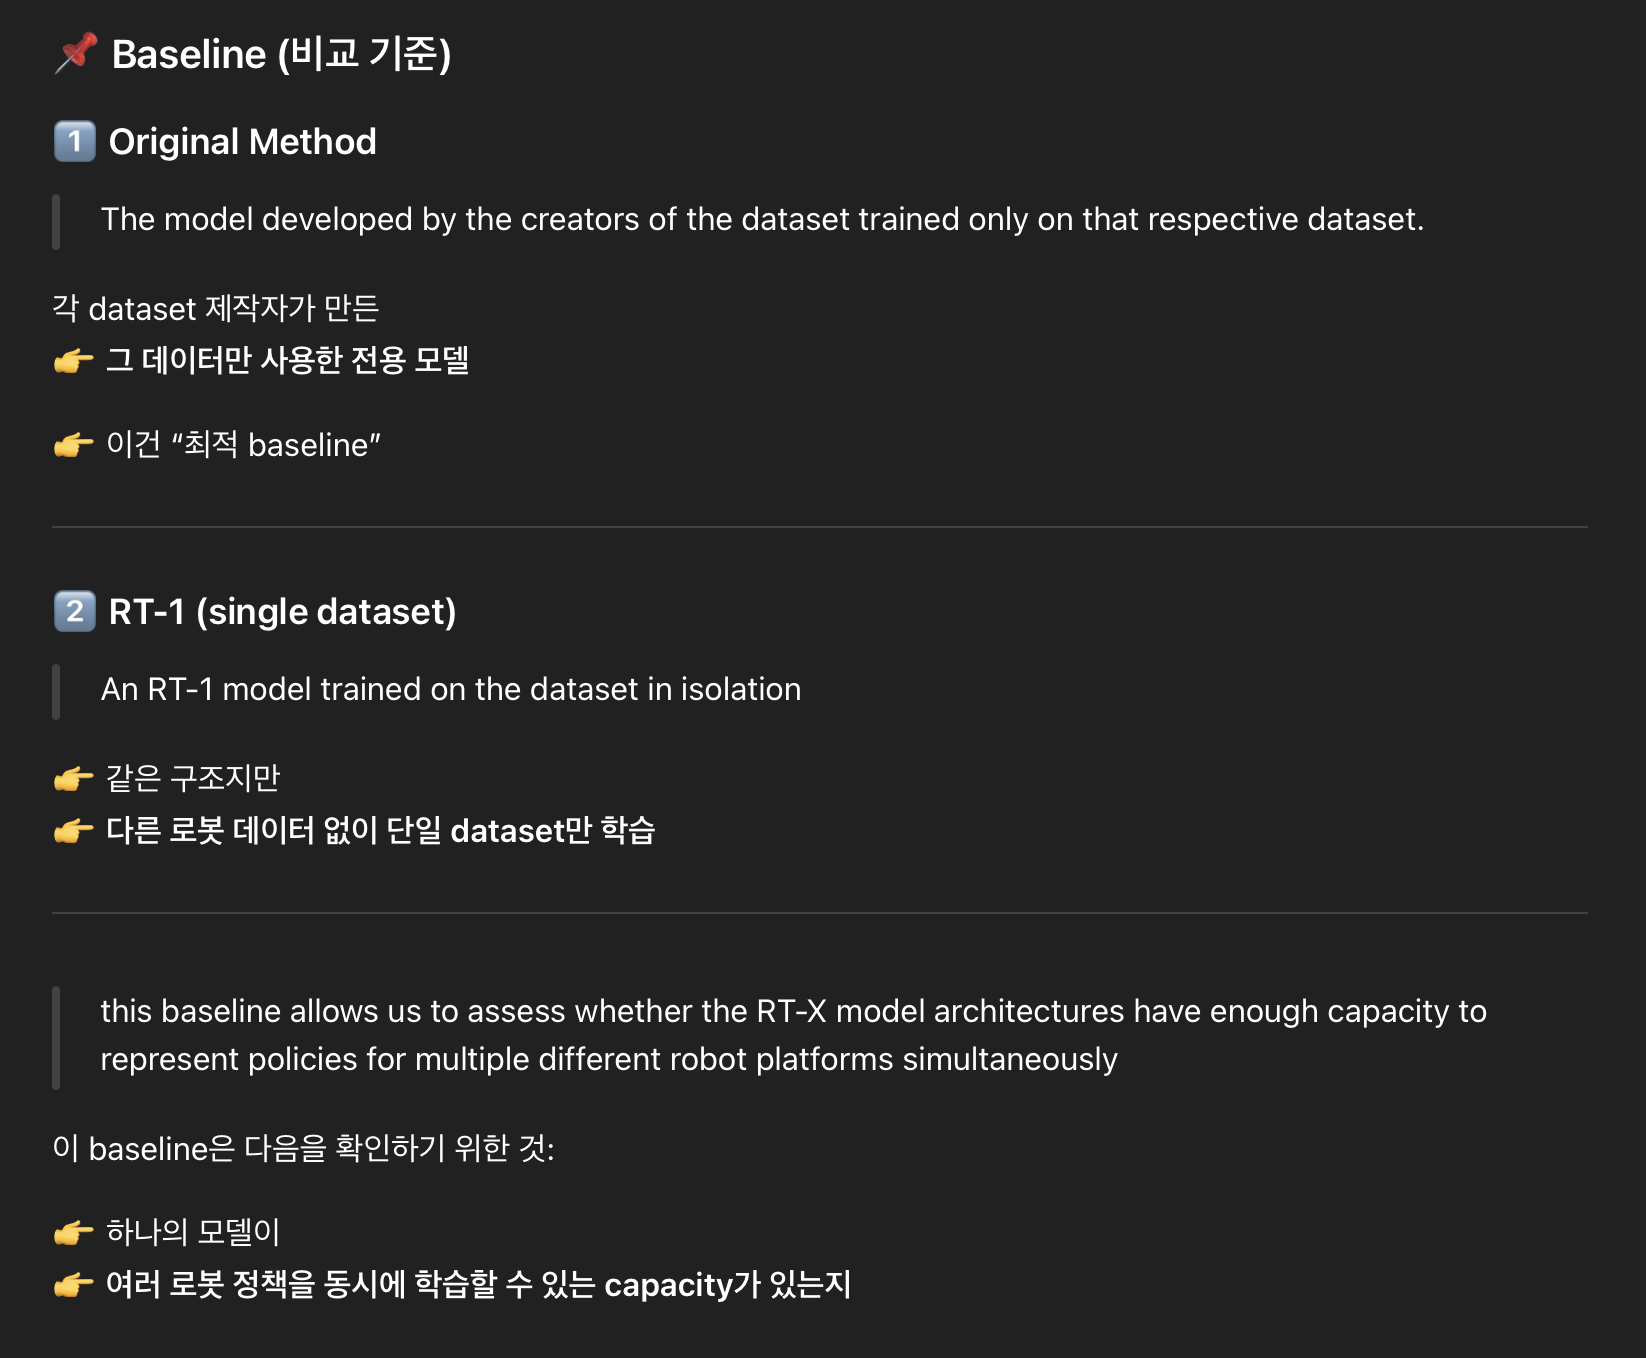
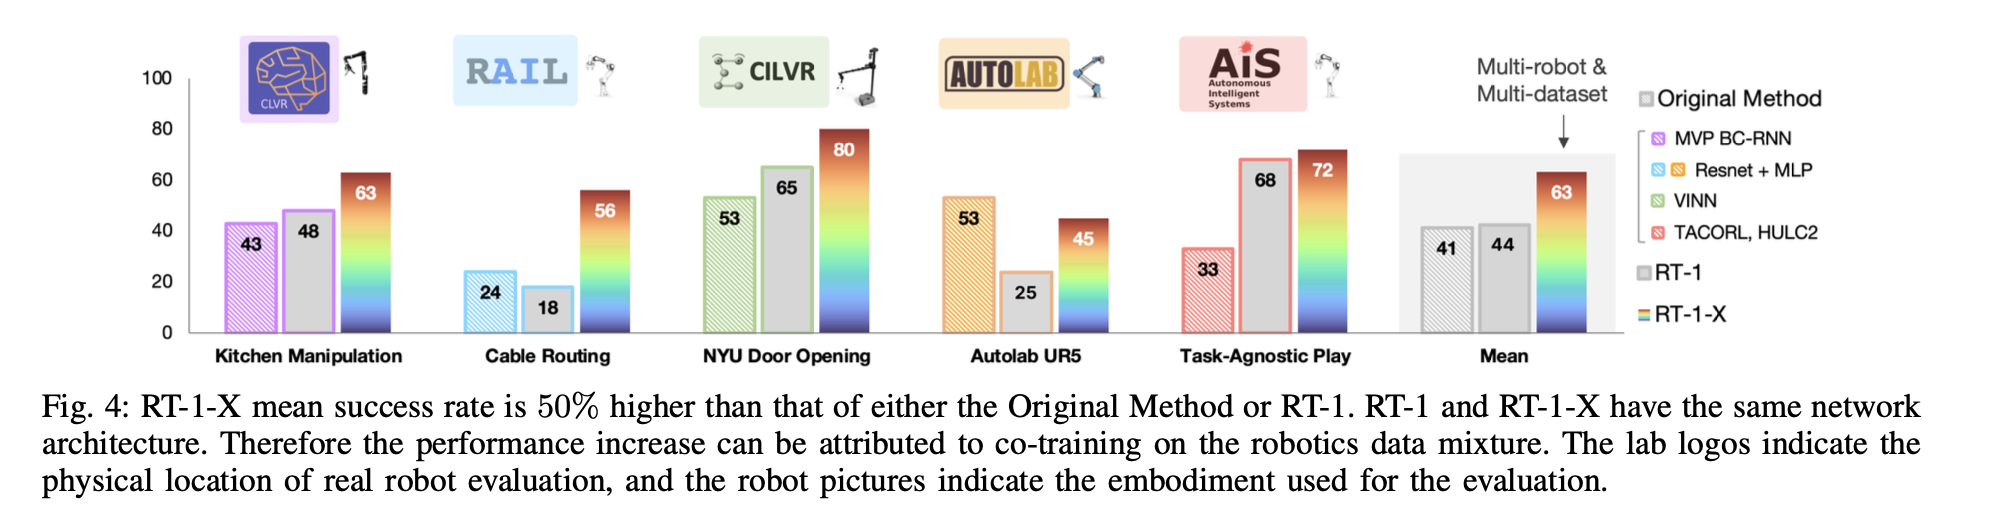
A. In-distribution performance across different embodiments
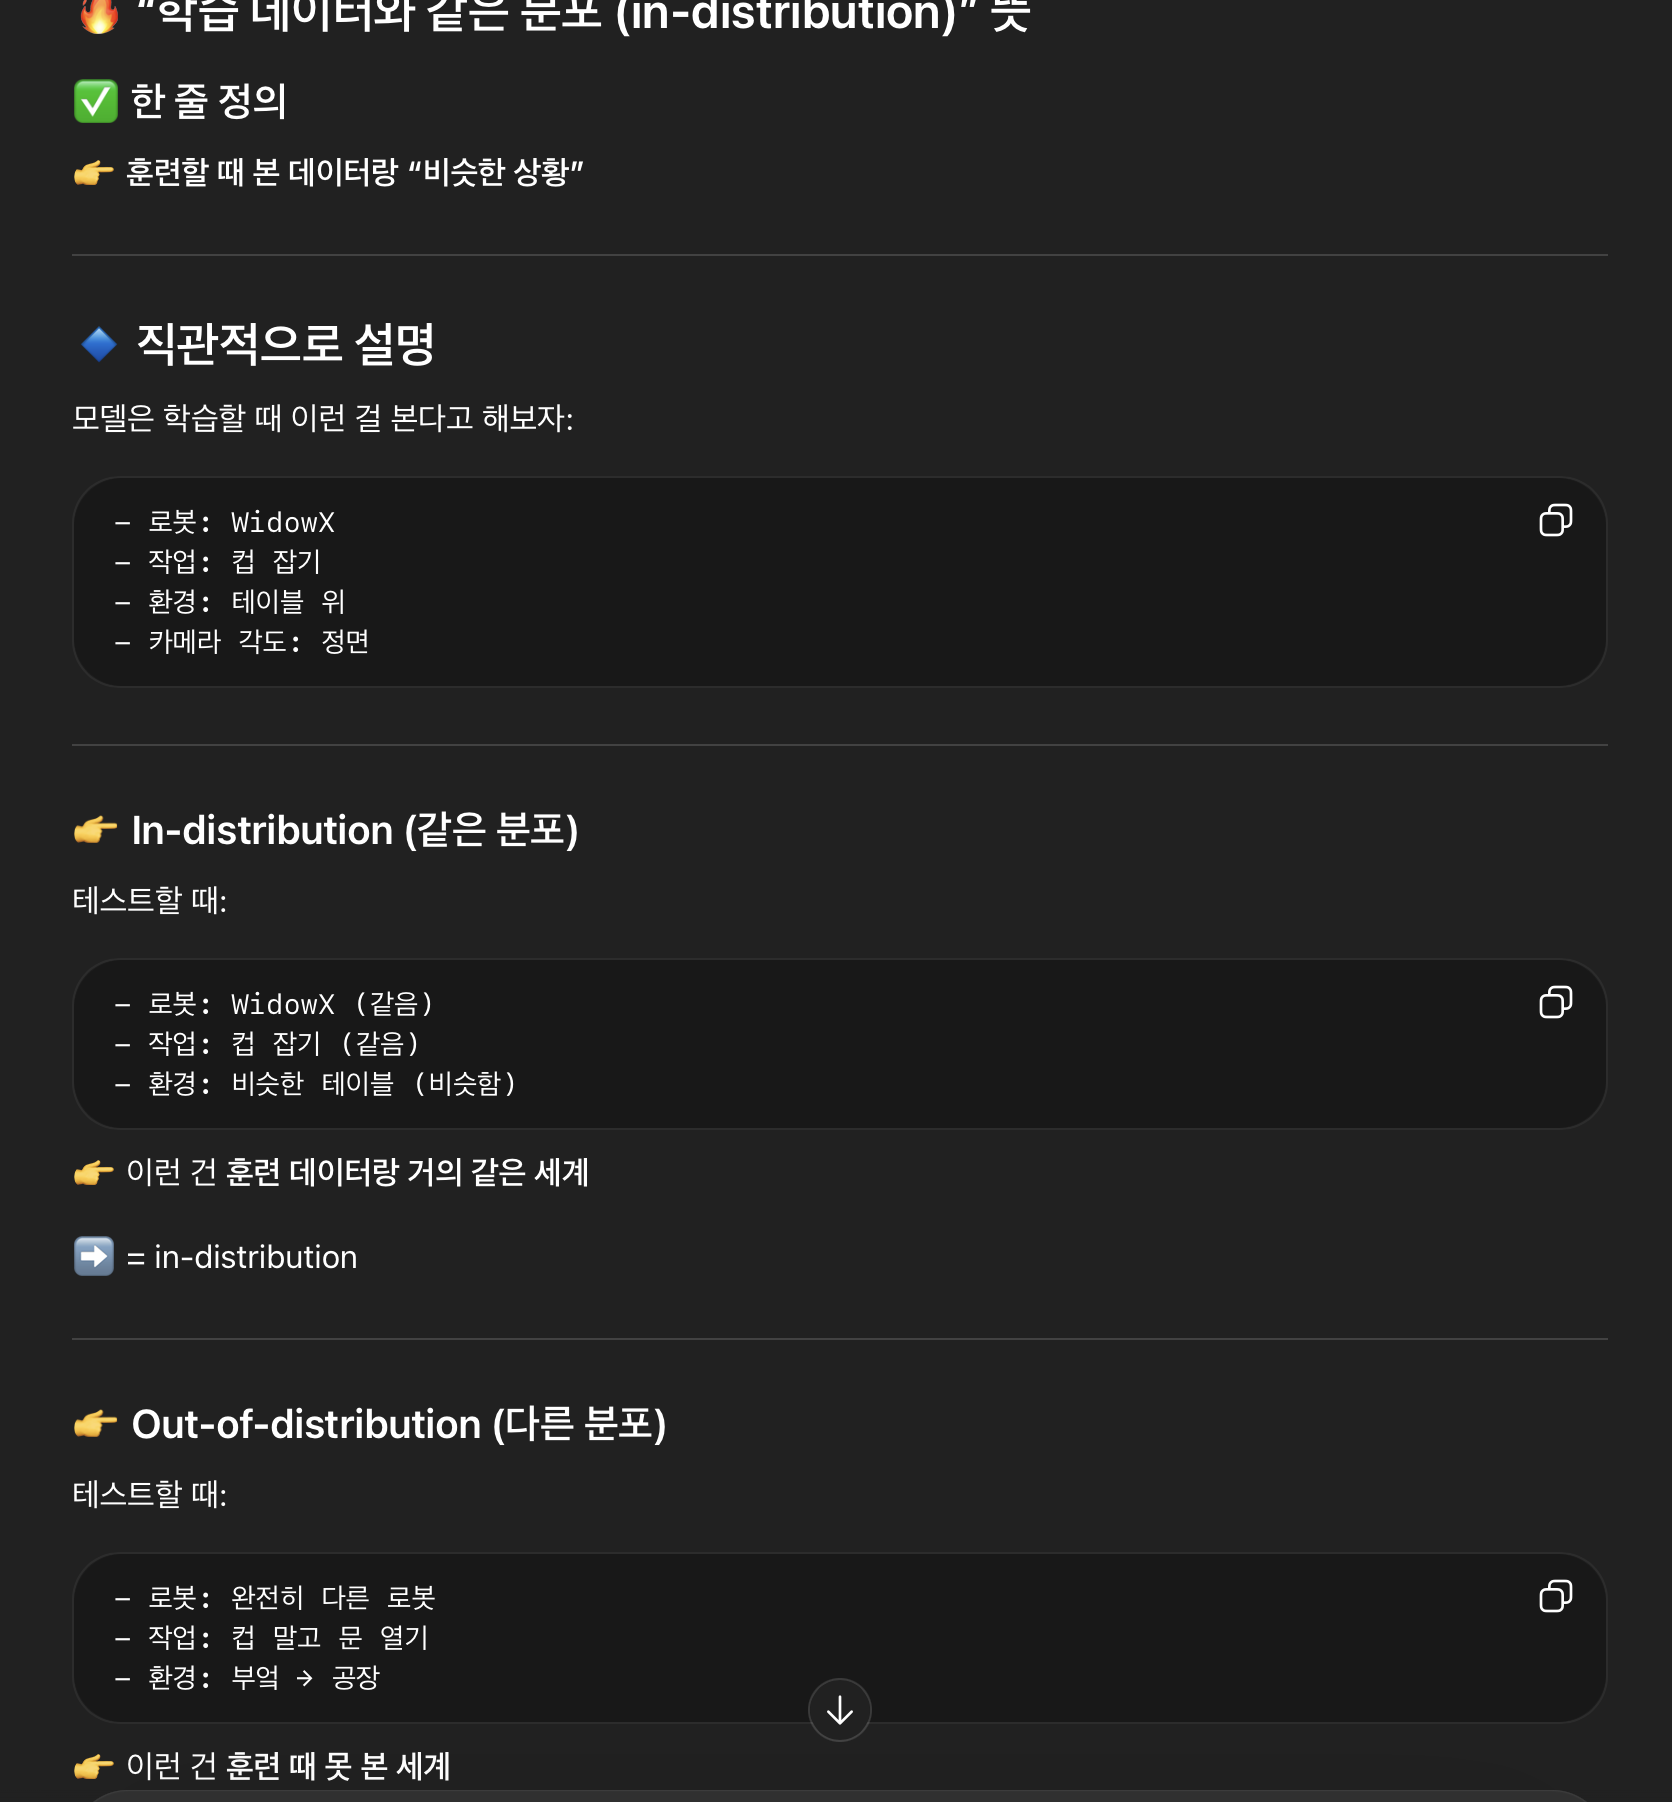
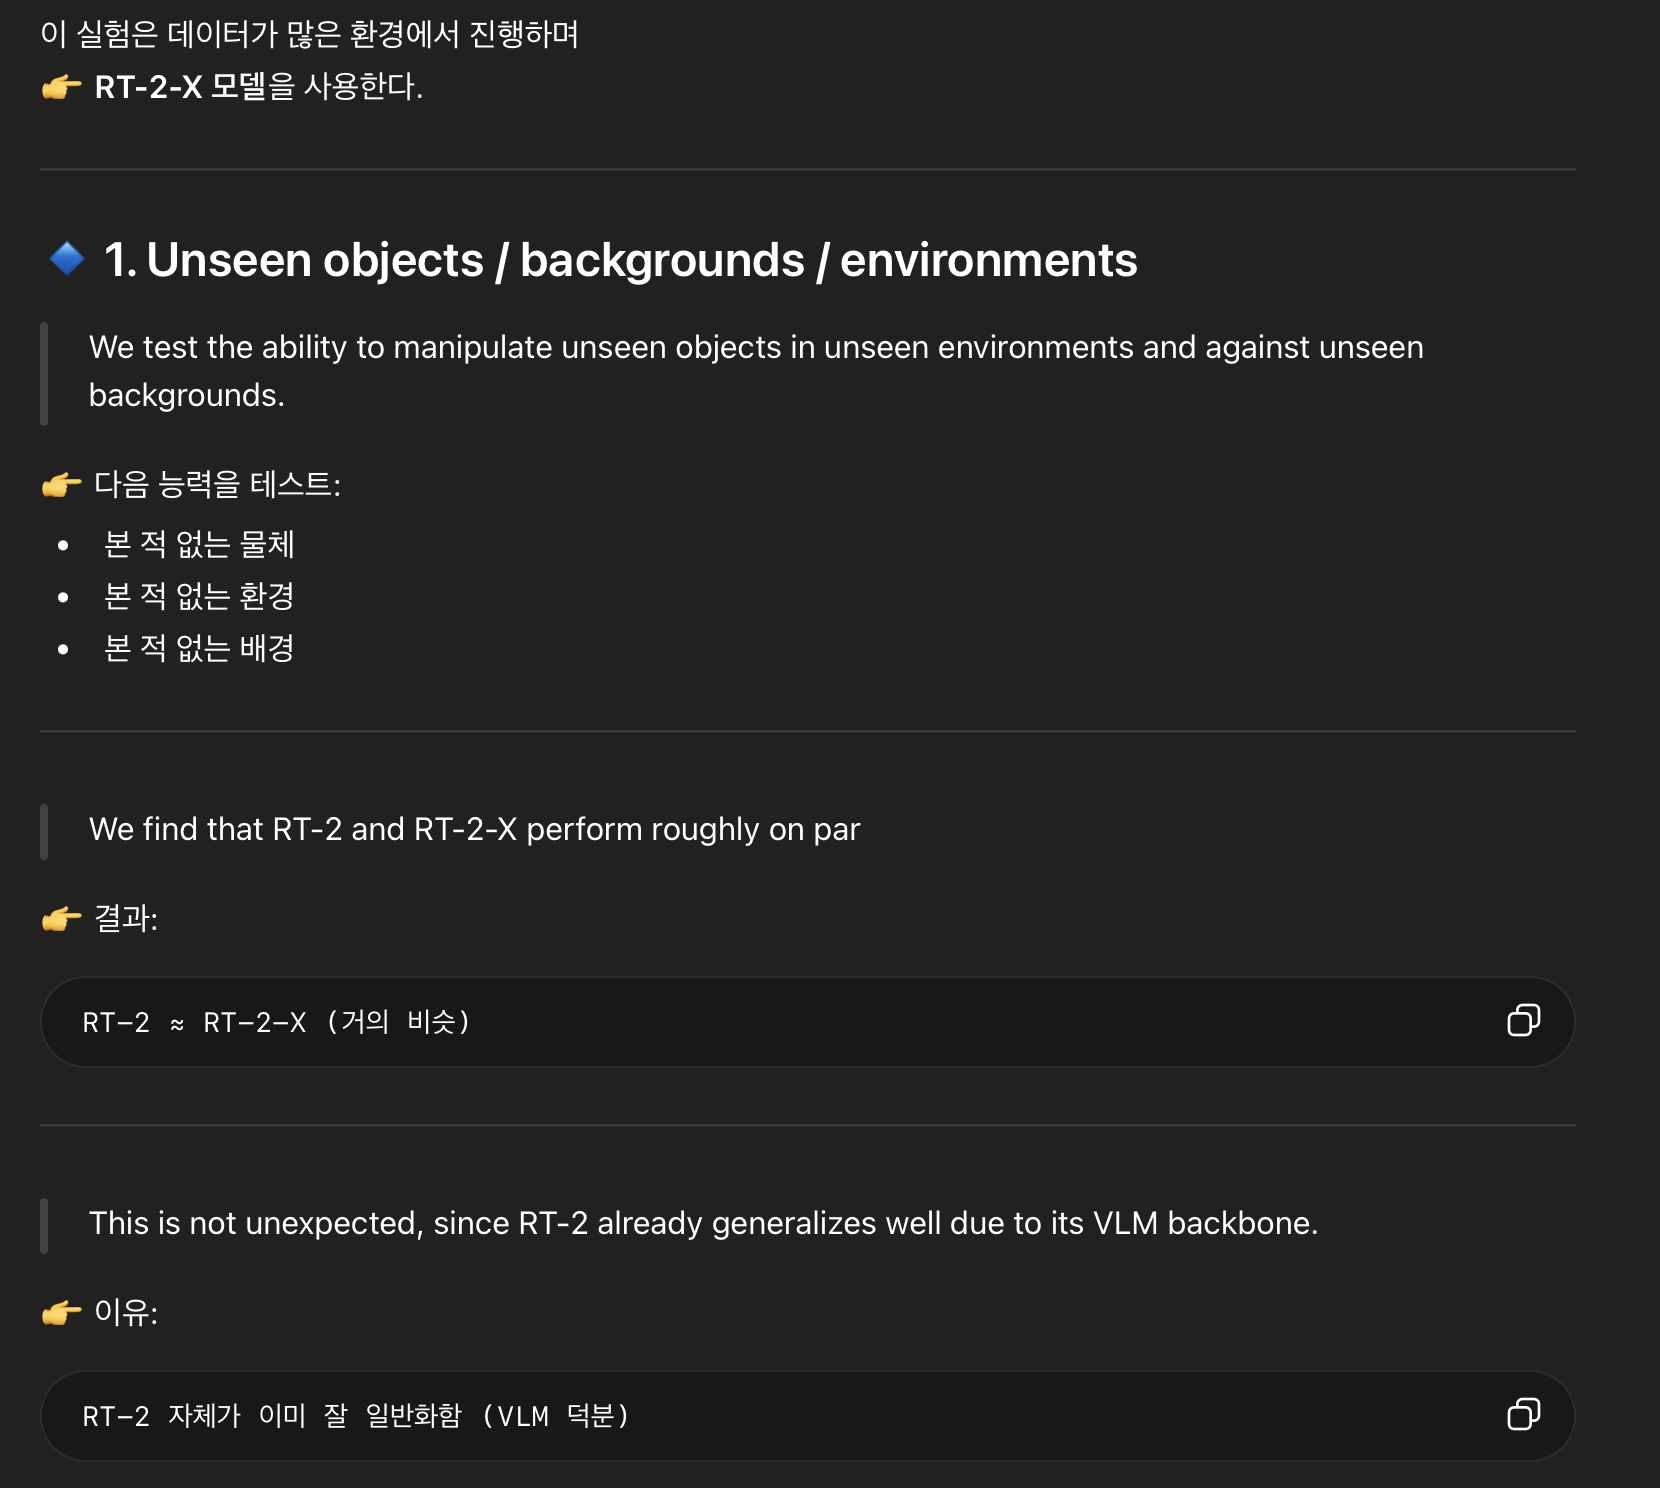
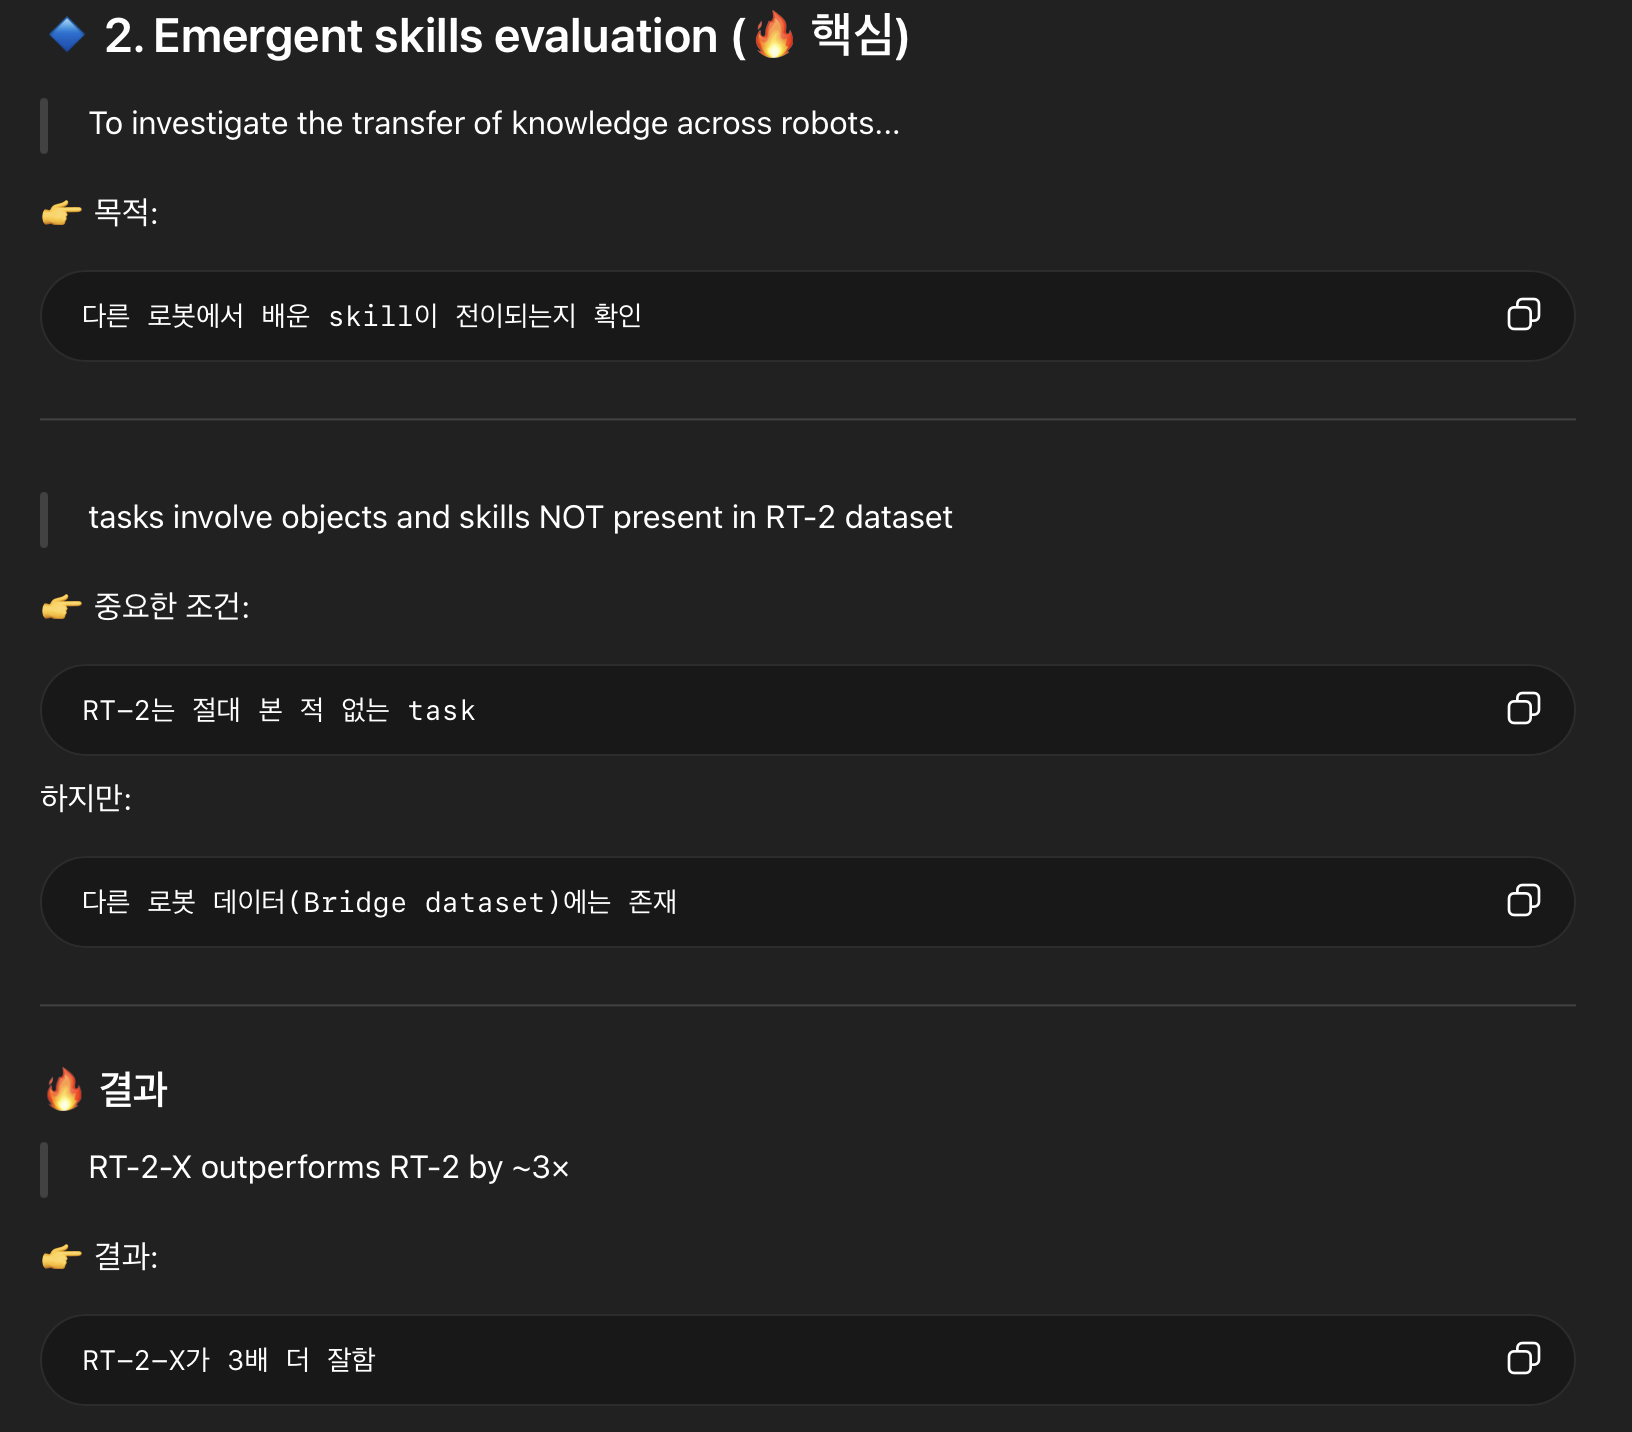
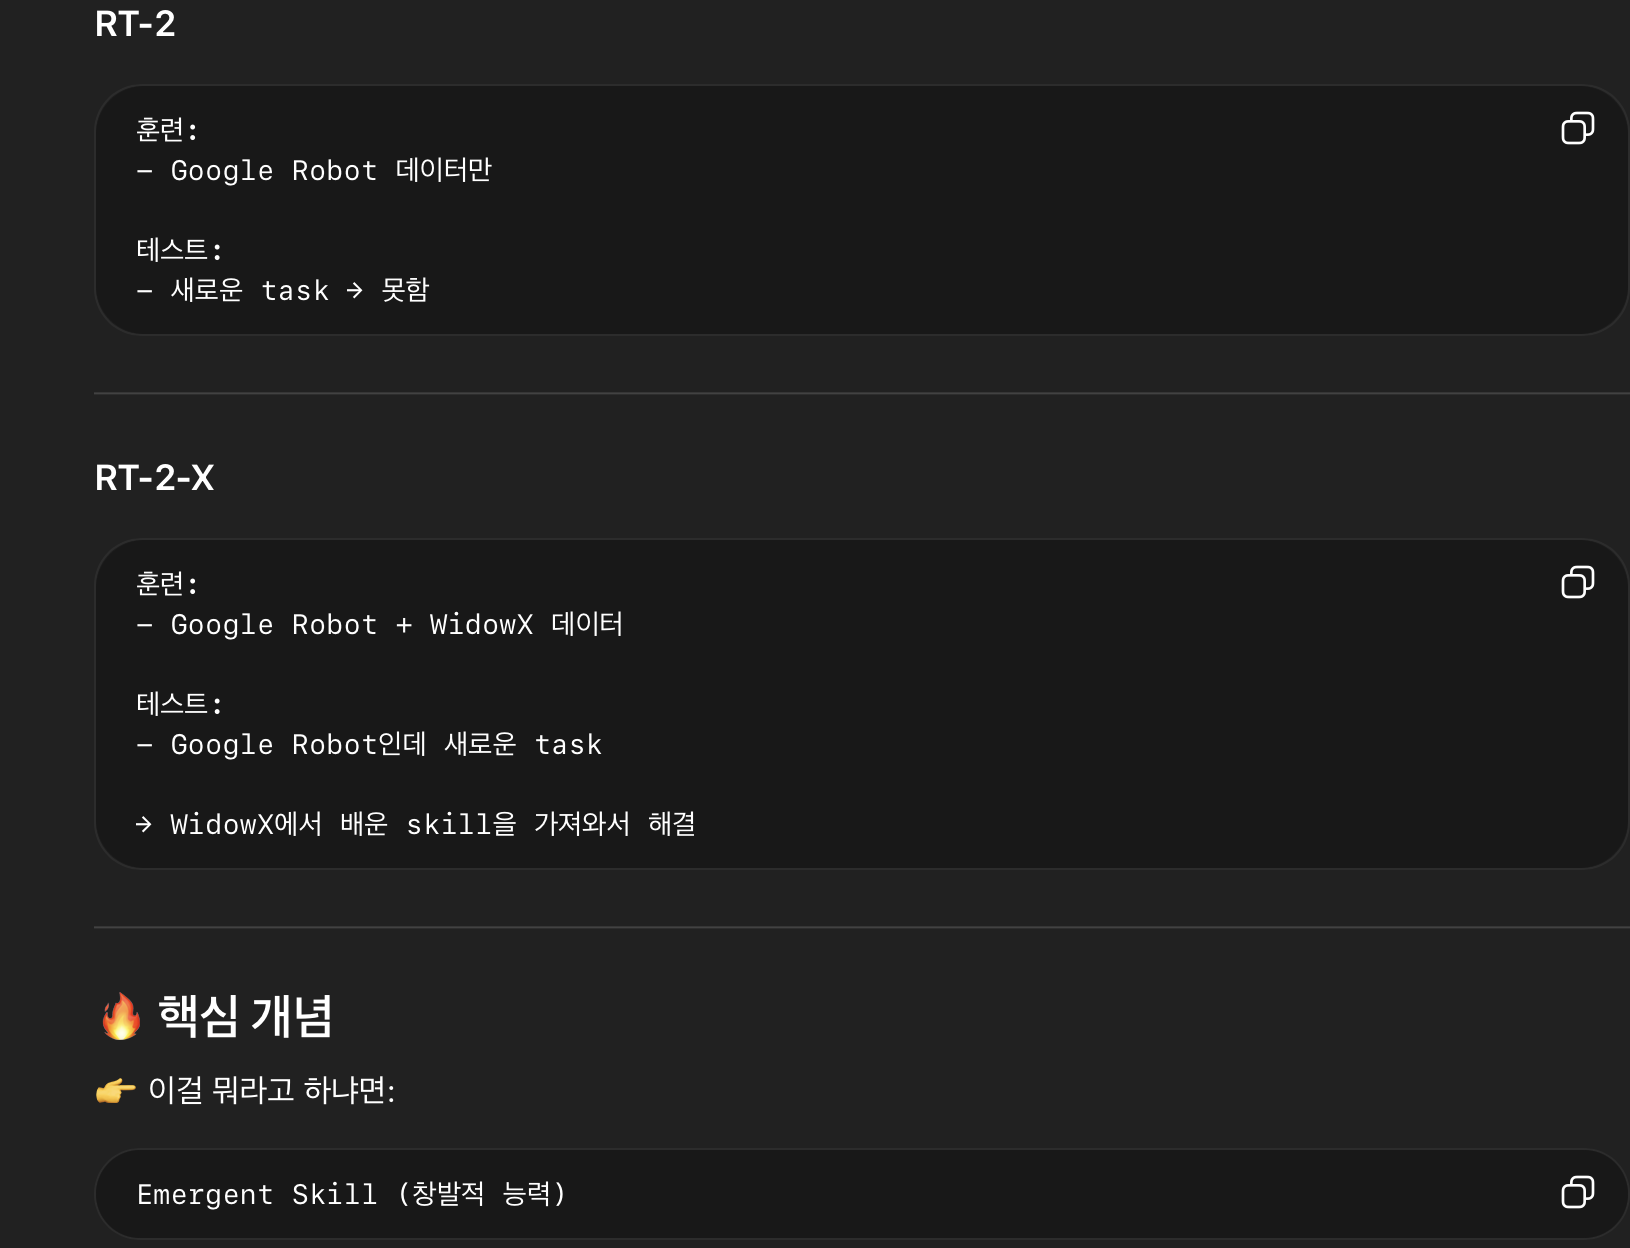
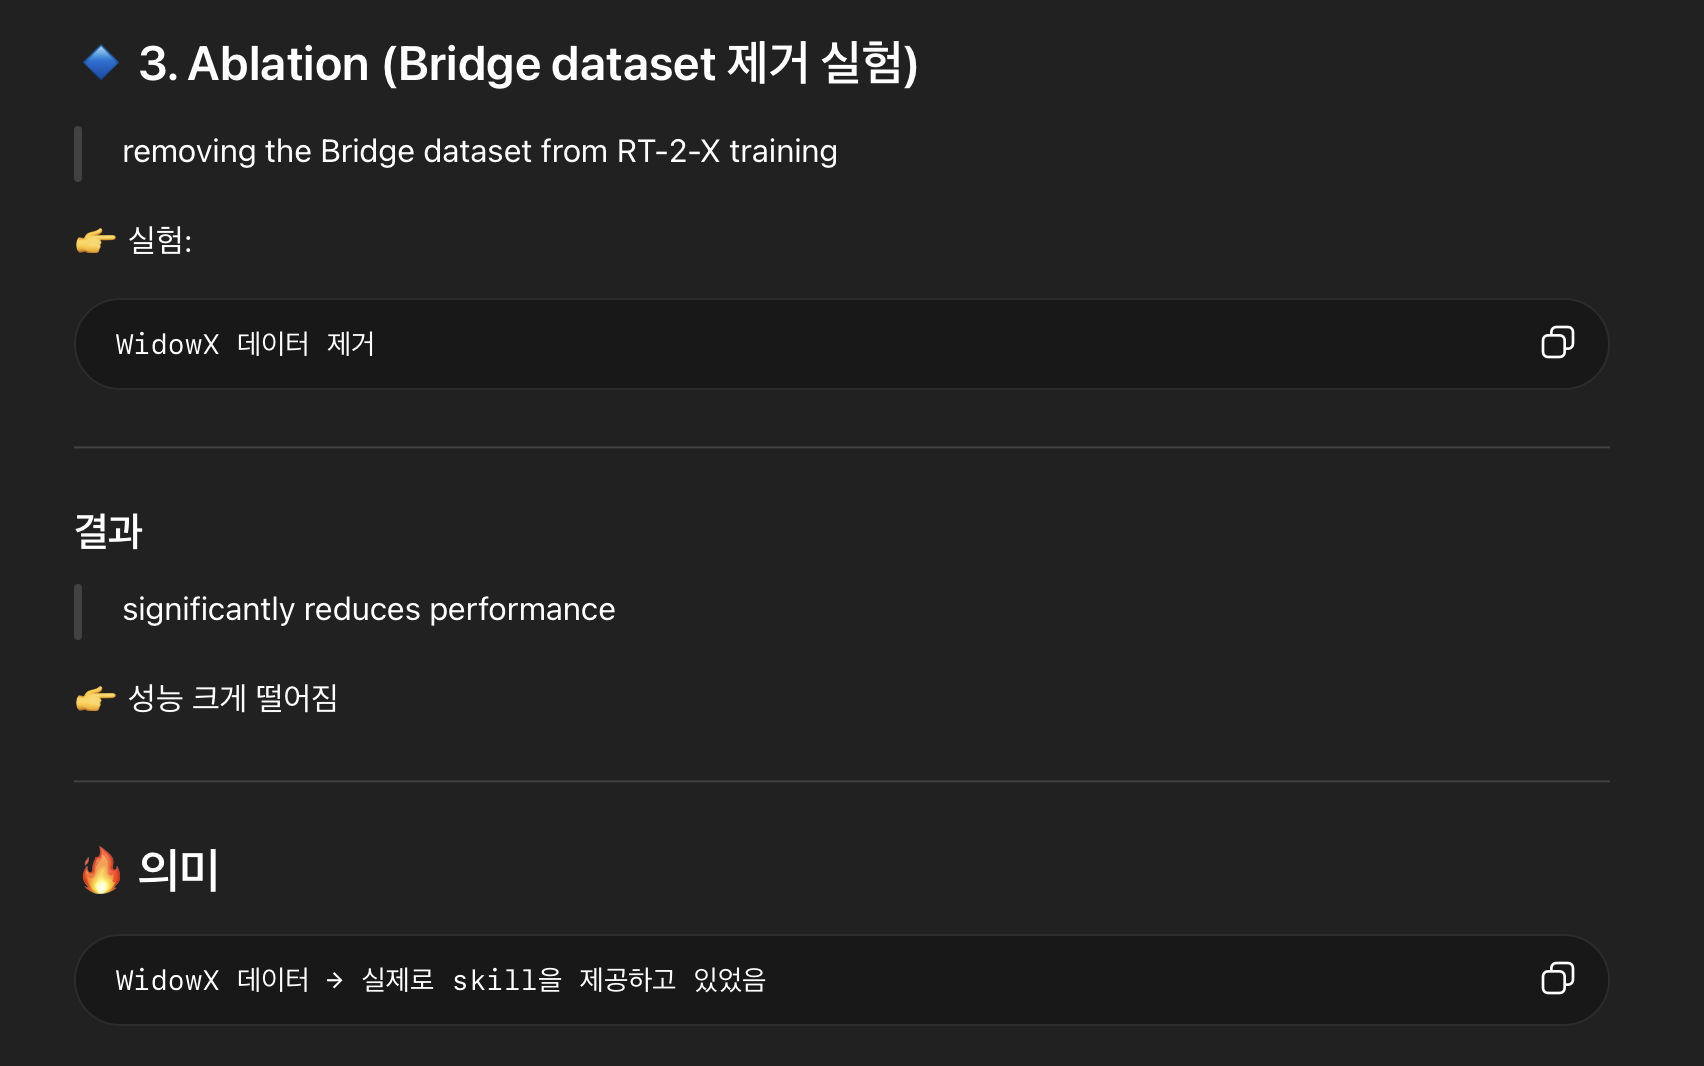
B. Improved generalization to out-of-distribution settings
C. Design decisions
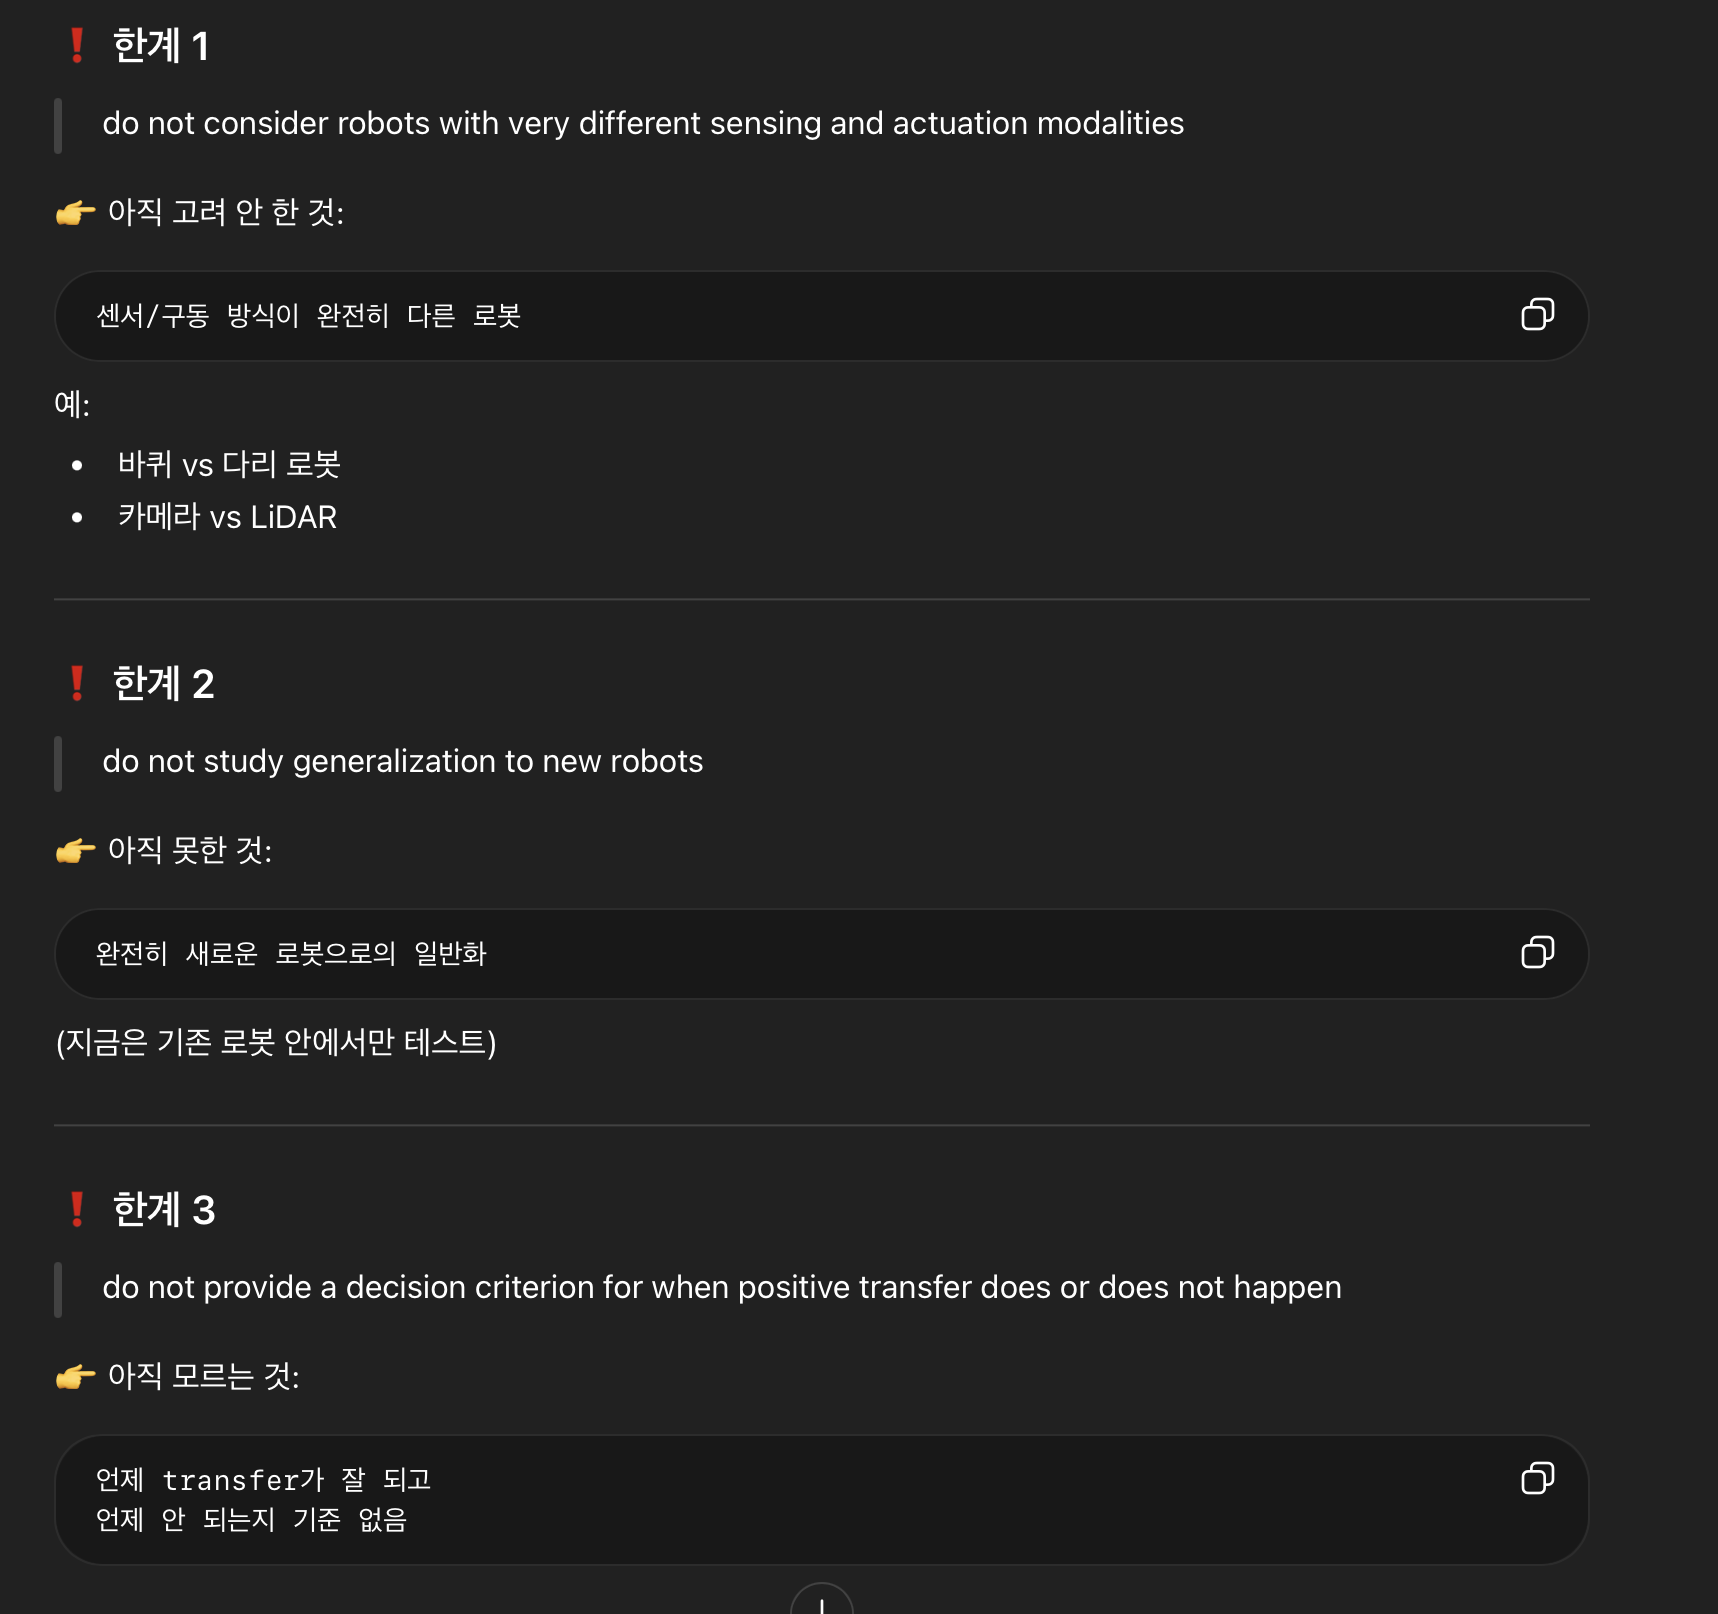
6. DISCUSSION, FUTURE WORK, AND OPEN PROBLEMS
Leave a Comment